优化 idea 生成 harness 时该优化什么:LLM judge 的 Goodhart、"精度–意外度"前沿与测量
实验报告(pilot 级,2026-10-20 至 10-21;两个公开空间)
本报告的结论全部来自预注册的小规模实验(pilot)。每个实验的判据都写在运行之前,失败和判定无效的结果也一并报告。数字可以用仓库里的缓存复现(见第 9 节)。
更正(2026-10-21,阶段 12,见 6i 节):M(测量推动前沿)在不受方向影响的先验下不成立。
- 原指标的问题:
- 先验问卷只问 P(HIGHER),LOWER 主张的先验取 100 − P(HIGHER),把"无交互"的概率也算给了 LOWER。
- 结果是:SV 候选中 LOWER 主张占 0%,而真主张中 LOWER 占 54–57%;HPOBench 上同一命题的两种措辞会拿到相反的意外标签。
- 测量臂恰好把主张推向 HIGHER,所以原指标上出现了"增益"。
- 补测结果:补测了三分类先验(P(更高)/P(更低)/P(无交互)),按预注册判据,M 在 3 个单元被否定,1 个 inconclusive。
- 不依赖阈值的检查:R 是"超出校准面板预期的为真条数"。测量在任何单元都没有显著提高 R。
- 不受影响的结论:A(judge Goodhart)与 D 仍然成立。
- 本节以下的旧内容:摘要与各节中基于原 SV 的数字保留不动,作为原指标下的记录;结论以 6i 节和 7.1 节为准。
摘要
我们研究的问题是:当一个 LLM 研究助手被要求提出"可验证、且别人想不到"的假设时,改进它的 harness(检索、角色分工、自我挑战、选择规则、提示文本)能不能让它找到更多真正意外的真结果?优化这种 harness 时,应该用什么作为 fitness?
为了让"真"可以测量,我们使用一个可以完全枚举、并已有实测结果的假设空间:NAS-Bench-201 上的条件交互主张,共 1740 条,其中 198 条为真。"意外"用模型群体的共享先验来定义:一条主张,如果其他模型认为它为真的概率低于 50%,就算低先验。SV(surprising-valid)指既为真、又低先验的主张。阶段 9 在第二个公开空间(HPOBench 表格 MLP 超参数基准,296 条主张,41 条为真)上重复了关键实验,这个空间的测量带有真实的单种子噪声。
九个阶段共做了约 2,640 次订阅 CLI 调用。阶段 5–9 用每臂 24 次全新运行做了确认、消融和跨空间重复,主要结果有三条:
A. 按 LLM judge 优化会 Goodhart(阶段 2 的 P1,阶段 5 和阶段 9 的 A-prec、A-judge:在 2 个公开空间 × 2 个模型上全部支持)。 同一个优化器、同样的预算下,以 judge 分为目标进化出来的 harness:
- judge 分上升:Sonnet 7.5 → 8.2(p = .018);Opus 8.2 → 8.9(p < .001);
- 精度崩塌:阶段 5 中 Sonnet 0.79 → 0.43,Opus 0.87 → 0.28;迁移到 HPOBench 空间(阶段 9)后 Sonnet .82 → .43,Opus .90 → .42,judge 分 +1.0 和 +1.8;迁移到私有空间后,Sonnet 从 0.40 跌到 0.03;
- 机制:优化器学会了禁止最常为真的主张类型,因为 judge 觉得它们显而易见;
- "SV 也下降"只部分成立:阶段 2 中 Sonnet 是 1.62 → 0.62,阶段 5 未重复(Sonnet 1.12 → 1.33,Opus 1.08 → 0.79,都不显著);阶段 9 中 Opus 4.17 → 2.46(Holm < .001),Sonnet 1.83 → 2.21(否定)。judge 臂总是移到"低精度、低先验"的一端,在先验较准的模型和空间上会损失真发现。
只以"为真"为目标时,harness 收敛到"机械、必然成立"的主张:先验升高 6 分,主张收窄,SV 不升(P2:支持)。
D. 只改内部推理的 harness 推不动前沿(D1:支持;D2:Sonnet 支持、Opus 不确定)。
- 在全新运行上检验了 19 个 harness,涵盖结构因子、三种 fitness 的进化结果、手写的先验规避、跨领域检索,以及"先写出 100 个实验、但不给结果"(阶段 8);
- 没有一个的 SV 显著超过直接生成;
- 以 SV 为 fitness 的优化器也找不到更好的 harness(P3:否定),被采纳的候选在新运行上回落(训练 1.67 → 新运行 1.25)。
M. 外部测量能推动前沿(原指标下 4 种模型 × 空间组合中 3 种支持;阶段 12 改用不受方向影响的先验后不成立,见 6i)。
- 做法:让模型先设计 100 个真实实验,读到结果后再提假设。
- NB201(阶段 5–8):
- Opus:SV 从 1.08 升到 2.12,差 +1.04,90% CI [+0.54, +1.58],Holm p = .003,精度 0.75,三批独立运行都是 2.12;加入现实噪声后仍成立(阶段 6 N1:+0.75,Holm .007)。测量质量主要影响精度(.75 → .65),不太影响 SV。
- Sonnet:SV 不变(+0.04,CI 上界 +0.38),精度从 0.79 跌到 0.45。
- HPOBench(阶段 9,测量是真实的单种子结果,符号一致率 0.70):
- Sonnet:1.83 → 2.71(+0.88,Holm .002),精度不降(.82 → .83);
- Opus:4.17 → 4.67(+0.50,Holm .019),精度不降(.90 → .89)。
- 因此,阶段 5 时"只对能按证据强度使用观测的模型有效"这一解释被削弱:唯一失败的是 Sonnet × NB201。
- 机制还没完全分清(NB201、Opus):
- 结果打乱后,SV 降到 1.42,精度降到 .58(干净 − 打乱 = +0.71,Holm .072,未过门槛);
- 明知没有结果时先设计实验,没有提升(阶段 8:Opus 1.25,Sonnet 1.21);
- 但"为测量而设计、最后不给结果"也有 1.83(阶段 7 D0)。
一句话结论:
- LLM judge 是一个会被优化器利用的坏目标:它奖励偏离先验,代价是精度。
- 只改内部推理的 harness 工程,包括"先把实验写出来",只是在精度和意外度之间换位置。
让模型设计并读取少量真实实验,在 4 种模型 × 空间组合中有 3 种显著增加了"真且意外"的发现。阶段 12 更正:这是补码先验造成的方向偏差。改用三分类先验后,测量没有增加"真且意外"的发现;只有一条事后线索:Opus 在严格阈值下每次多约 1 条。- 用 LLM 面板衡量"意外"时,问题必须对方向不变(更高 / 更低 / 无效应);补码问法足以制造出一个预注册检验也会通过的假效应。
1. 背景与动机
1.1 问题来源
- 自主研究 agent(autoresearch、AI Scientist 一类)和自我改进的 harness(Harness²、Prime Agent、ADAS/AFlow),都需要一个打分信号来判断"哪个想法更好"、"哪个 harness 更好"。
- 最便宜的信号是 LLM judge,但 judge 是否和真实价值一致,并没有在优化闭环里检验过。
- 我们此前的一系列观察(第 3 节的前期 pilot)指向同一个现象:不同 LLM 共享一套先验,模型之间的一致远高于它们和真值的一致;自我挑战式的"反思"只是在这套先验内部移动。
1.2 研究问题
- RQ1:以 judge 分为 fitness 优化 idea 生成 harness,会不会在实测真值上 Goodhart?
- RQ2:只以"为真"为 fitness,会不会坍缩到安全、高先验的主张?
- RQ3:以"为真且低先验"(SV)为 fitness,能否同时避开上面两种失败?
- RQ4(事后提出、预注册检验):harness 层面的干预,能否把"精度–意外度"前沿往外推?
1.3 最接近的已有工作
| 工作 | 做了什么 | 与本文的差别 |
|---|---|---|
| Si et al. 2601.14525 | 用执行结果作为奖励训练 ideation(RL / 进化搜索);RL 使 idea 求稳、多样性坍缩;尝试过一个 token Jaccard 多样性奖励,被提前停止 | 优化的是模型权重;多样性按表面 token 衡量,不以"为真"为前提,也不是相对于跨模型的共享先验 |
| HindSight 2603.15164 | 基于后续真实研究成果的 HindSight 分与 LLM 判定的新颖度负相关(ρ = −0.29,p < .01) | 只做相关分析,没有放进优化闭环 |
| Gao et al. 2210.10760 | 奖励模型过度优化的 scaling law | 一般性的 RLHF 设定,不是研究 ideation,也没有实测的科学真值 |
| IdeaScientist 2610.04074 | 按角色做 LoRA + GRPO,奖励 = judge + 参考匹配 + 引用 F1;跨领域检索使新颖度 +30.7 | 奖励里仍以 judge 为主;我们在实测空间上发现跨领域检索不增加 SV(阶段 1:p = .73) |
| ADAS 2408.08435、AFlow 2410.10762、MaAS 2502.04180、Harness² 2610.14224 | 自动搜索 agent 流程或 harness | 目标是任务准确率;本文的问题是 fitness 本身选得对不对 |
| PromptBreeder 2309.16797、OPRO 2309.03409、GEPA 2507.19457 | prompt 进化 | 同上 |
| Huang et al. 2310.01798、FlipFlop 2311.08596、Sharma et al. 2310.13548、SycEval 2502.08177 | 没有外部反馈时,自我纠错失败,并会顺从挑战 | 二值对错任务;我们的前期 pilot 用实测效应做了对照 |
| Si et al. 2409.04109 | 人类评审认为 LLM 的 idea 更新颖、可行性略低 | 人类评审,没有实测真值 |
| AIDE² 2609.26457(递归自改进的 AI 研究 agent) | agent 改写自己的代码,用私有 held-out 任务分数决定是否接受;一次 8 天运行接受了 7 次改写(分数 0.703 → 0.778),held-out 任务上 reward hacking 从 55% 降到 32%;作者认为把公开信号与私有信号分开能抑制 reward hacking,并承认噪声会让错误改写成为 incumbent | 优化对象是执行型 agent,选择信号是可执行的真值分数;不测新颖度、没有 judge 作为 fitness、没有"测量 vs 推理"的消融。它的成功条件(私有真值)正是 ideation 里缺的东西,见 7.2 |
2. 实验平台
2.1 可验证的假设空间(NAS-Bench-201)
- 主张形式:"把边 j 的算子改为 b 时,对验证准确率的效应,在父 cell 的边 k 为算子 c 时更高(或更低)。"
- 父 cell 取遍 NB201 的全部 15,625 个 cell;
- 条件两侧各需至少 100 个父 cell;
- 一共 870 个格子,对应 1740 条有方向的主张。
- 判真:
- 规则:CIFAR-10、CIFAR-100、ImageNet16-120 三个数据集上,条件内外的效应差同号,且最小 |差| ≥ 2.0 个百分点;
- 结果:198 个格子为真;
- 随机抽一条主张,为真的概率是 11.4%,为 SV 的概率是 3.9%;
- 阈值在任何生成之前写定。之所以用效应量阈值,是因为 NB201 样本量很大,几乎所有交互都"统计显著"。
- 共享先验:
- Haiku、Sonnet、Opus 各自对全部 870 个格子给出 P(更高),每次调用 30 个格子,共 87 次调用;
- 一条主张的留一先验 = 除生成模型之外其他模型的均值;
- SV = 为真,且留一先验 < 50。
- 为什么选这个空间:
- 真值完全可枚举,所以精度、召回、意外度都能精确算出;
- 输出契约是 JSON 结构化主张,生成结果可以直接映射回空间。
2.2 迁移测试空间(私有,未公开)
- 一个私有的 CTR 模型配置基准,覆盖 6 个推荐数据集,主张形式相同,是单字段编辑 × 条件字段。
- 共 430 条不同主张,其中 21 条为真。
- 模型没见过这份数据。它只用于描述性的迁移测试,代码和数据都不在本仓库,报告只给汇总数字。
2.3 Harness 与运行
- 每个角色是一次
claude -p调用(关闭工具,严格 MCP 配置,在临时目录里运行)。 - 检索走 arXiv / OpenAlex / Semantic Scholar 的本地检索器。屏蔽名单会去掉分析 NAS-Bench 表格本身的论文:阶段 1 在 294 条结果里屏蔽了 11 条。
- 输出固定为 10 条结构化主张。
- harness 字段:
| 字段 | 取值 |
|---|---|
| retrieval | none / in_domain / cross_domain |
| roles | single / gap_innovator / gap_innovator_critic |
| challenge | none / flaw(找漏洞后修改)/ negate(列出默认假设并取反) |
| pool | 10 / 20 / 30(多于 10 条时再选出 10 条) |
| select | likely_true / prior_avoid(选别的模型想不到、但可能为真的)/ custom |
| strategy / select_rule | ≤ 150 / ≤ 50 词的自由文本 |
- 不变式:文本字段里不允许出现两个空间的专有词(算子名、字段名、数据集名等),确保优化器只能学"怎么想",学不到"答案是什么"。
3. 前期 pilot(私有空间,仅给汇总)
这几项 pilot 用的是私有 CTR 基准,代码不在本仓库,这里只记录与主线有关的结论。
| 编号 | 问题 | 预注册结论 | 要点 |
|---|---|---|---|
| Q1 | 不同模型是否共享一套先验 | 不确定 | 三个大模型(Opus、Haiku、GPT 系)两两之间的打分一致约为 0.50;它们与真值的一致只有约 0.20;这部分共享与父配置无关 |
| P1 | 自我挑战推翻判断时是否有精度 | 支持(窄) | 内省式挑战推翻判断时不分对错:Sonnet 推翻了 20%,其中只有 42% 原本是错的,几乎等于初始错误率 41%;只有引入外部测量时,推翻才有精度(推翻精度提升约 +0.42) |
| P2 | 模型会不会被前提锚定 | 判定无效(设计缺陷) | 理想观察者因输出截断和分层抽样而失效;探索性观察:前提反而被低估,没有锚定 |
| P3 | 强迫找漏洞会不会拓展搜索边界 | H1 支持,H2 / H3 不确定 | 找漏洞后的输出与直接生成高度重合(Jaccard 0.62),先验不变;假设取反和跨领域类比让先验略降 4–6 分;禁用常见理由时精度跌到 3%,低于随机 |
这些 pilot 共同说明:**改变提问方式只是在先验附近移动,偏离先验的代价是精度。**这促成了下面的 harness 研究。
4. 阶段 1:结构旋钮筛查
设计(PREREG_s1.md):
- 用 L9 正交表安排 R(检索)× G(角色)× C(挑战)× S(选择)四个三水平因子,共 9 个配置;
- 生成模型是 Sonnet,每个配置跑 8 次,共 72 次运行;
- judge 用 Opus,给每组输出打新颖度和质量分(1–10)。
结果(RESULT_s1.md):
| 配置 (R,G,C,S) | SV/次 | 精度 | 平均先验 | token | judge 新颖度 |
|---|---|---|---|---|---|
| (0,0,0,0) 直接生成 | 1.25 | .76 | 63.1 | 5k | 2.0 |
| (1,2,0,1) | 1.50 | .75 | 61.8 | 37k | 2.0 |
| (0,2,2,2) | 0.38 | .31 | 60.9 | 34k | 2.6 |
| (1,1,2,0) | 0.12 | .25 | 56.3 | 16k | 3.0 |
| (2,1,0,2) | 1.12 | .20 | 52.4 | 25k | 3.0 |
| 其余 4 个 | 1.00–1.12 | .62–.79 | 62–69 | 22–33k | 2.0–2.2 |
按预注册判据看:
- K1 旋钮主效应:不确定。
- 挑战因子的 p = .002,方向是"假设取反"最差(不挑战 1.29、找漏洞 1.04、取反 0.54 条/次);
- 但最好和最差水平只差 0.75 条,不到预设的 1 条;
- 跨领域检索几乎没有作用(p = .73)。
- K2 judge 能否代表 SV:不能,阶段 2 的前提成立。
- ρ(judge 新颖度, SV) = −0.24;
- ρ(新颖度, 平均先验) = −0.58:judge 眼里的"新",基本就是"低先验";
- ρ(质量, 为真条数) = +0.53。
- K3 成本归一化:直接生成第一。
事后观察(未预注册):精度崩塌的 3 个配置,都同时开了两个"推新颖"的旋钮(多角色、假设取反、先验规避选择中的任意两个);只开一个时,精度仍有 0.68–0.79。
5. 阶段 2:同一个优化器,三种 fitness
设计(PREREG_s2.md):
- 三个臂共用同一个优化器,只有目标不同:
- J:judge 分(新颖度 + 质量);
- V:为真条数;
- SV:为真且低先验的条数。
- 优化器是 Harness² 式的 propose → probe → select:
- proposer 是 Opus,它看到字段说明、目标的文字描述、历史得分,以及当前最优 harness 的一份不带标签的输出;
- 每轮提出 3 个候选,每个候选用 Sonnet 跑 6 次;
- 平均分更高、且 token ≤ 40k 时采纳;
- 共 3 轮。
- 最终评测:用全新的 rep(训练时没用过),每个最终 harness 在 NB201 和私有 CTR 空间上各跑 8 次。
5.1 学到了什么
- J 臂:
- 最终 harness 是 gap finder + innovator + critic,加假设取反,再从 20 条里自定义选择;
- 它的 strategy 明确禁止两类"专家觉得显而易见"的主张:一类以被编辑字段自身的当前值为条件,另一类是让被编辑部件失效的条件;
- 改为要求跨字段的非平凡机制,比如替代、瓶颈、干扰。
- V 臂:
- 最终 harness 是同领域检索加三角色;
- 它的 strategy 只允许恰好这两类主张("自条件"和"断开"),并要求 critic 换掉任何方向不确定的主张。
- SV 臂:3 轮里没有任何候选超过起点,最终 harness 就是直接生成。
两个臂学到的规则正好相反:**judge 惩罚的,正是真值奖励的。**生成结果里"以自身字段为条件"的主张占比:直接生成 49%,V 臂 52%,J 臂 0%。
5.2 最终评测(全新运行)
NB201:
| harness | judge 分 | 精度 | SV/次 | 平均留一先验 | 8 次运行合并的不同主张数 | token |
|---|---|---|---|---|---|---|
| 直接生成(= SV 臂最终版) | 7.5 | .78 | 1.62 | 62.7 | 36 | 5k |
| J 臂最终版 | 8.2 | .29 | 0.62 | 56.7 | 70 | 33k |
| V 臂最终版 | 8.4 | .79 | 1.12 | 68.9 | 32 | 23k |
私有 CTR 空间(迁移,描述性):
| harness | judge 分 | 精度 | SV/次 | 平均先验 |
|---|---|---|---|---|
| 直接生成 | 6.6 | .40 | 0.12 | 52.9 |
| J 臂最终版 | 8.8 | .03 | 0.00 | 42.1 |
| V 臂最终版 | 7.5 | .36 | 0.00 | 49.8 |
5.3 预注册判定
- P1 judge 的 Goodhart:支持。 judge 分上升(p = .018),SV ≤ 直接生成 + 0.3。
- P2 求稳坍缩:支持。 平均先验升高 6.2 分(≥ 3),不同主张数 32 ≤ 36。
- P3 SV 目标更好:否定。 SV 臂最终版就是直接生成。
- 主线"SV 目标能同时避开两种失败":不成立。
5.4 一个实现 bug(如实报告)
- 不变式正则
conv\w*本来要拦卷积算子名,却同时拦掉了普通单词 "conventional"。 - 被误杀的候选:SV 臂第 1 轮 3 个里有 2 个,V 臂第 2 轮 1 个。
- 已修复为
conv(olution\w*|\d\w*)?,并在阶段 3 重跑了 SV 臂。
6. 阶段 3:前沿能不能推动(论点 D)
设计(PREREG_s3.md):
- E1,修复 bug 后重跑 SV 臂(臂名 SV2):起点用 12 次运行估分,减小起点运气偏高的影响;最终的 harness 再用 8 次全新运行评测。
- E2,换生成模型为 Opus:5 个 harness 在看到 Opus 结果之前选定,每个跑 8 次全新运行;留一先验 = Haiku 与 Sonnet 的均值。
- D1(推不动):每个生成模型上,所有 harness 和直接生成比较 SV,单侧置换检验加 Holm 校正,结果不显著,且没有一个比直接生成多出 0.5 以上。
- D2(前沿形状):在不同 harness 之间,ρ(平均先验, 精度) ≥ 0.5。
6.1 结果
- E1:
- 9 个候选里只有 1 个在第 3 轮被采纳:生成 30 条,然后选出"自己估计 ≥ 55% 为真、但预计其他模型 < 50%"的 10 条;
- 它的训练分 1.67,新运行 1.25(直接生成 1.62),精度 0.91;
- 这条"先验规避"规则实际上让输出更安全,而不是更意外。
- E2(Opus 生成,新运行):
| harness | SV/次 | 精度 | 平均先验 |
|---|---|---|---|
| 直接生成 | 1.00 | .79 | 67.8 |
| J 臂最终版 | 1.12 | .25 | 44.3 |
| V 臂最终版 | 1.25 | .72 | 63.8 |
| 先验规避选择 | 0.62 | .40 | 68.9 |
| 跨领域检索 + 找漏洞 | 0.62 | .65 | 59.1 |
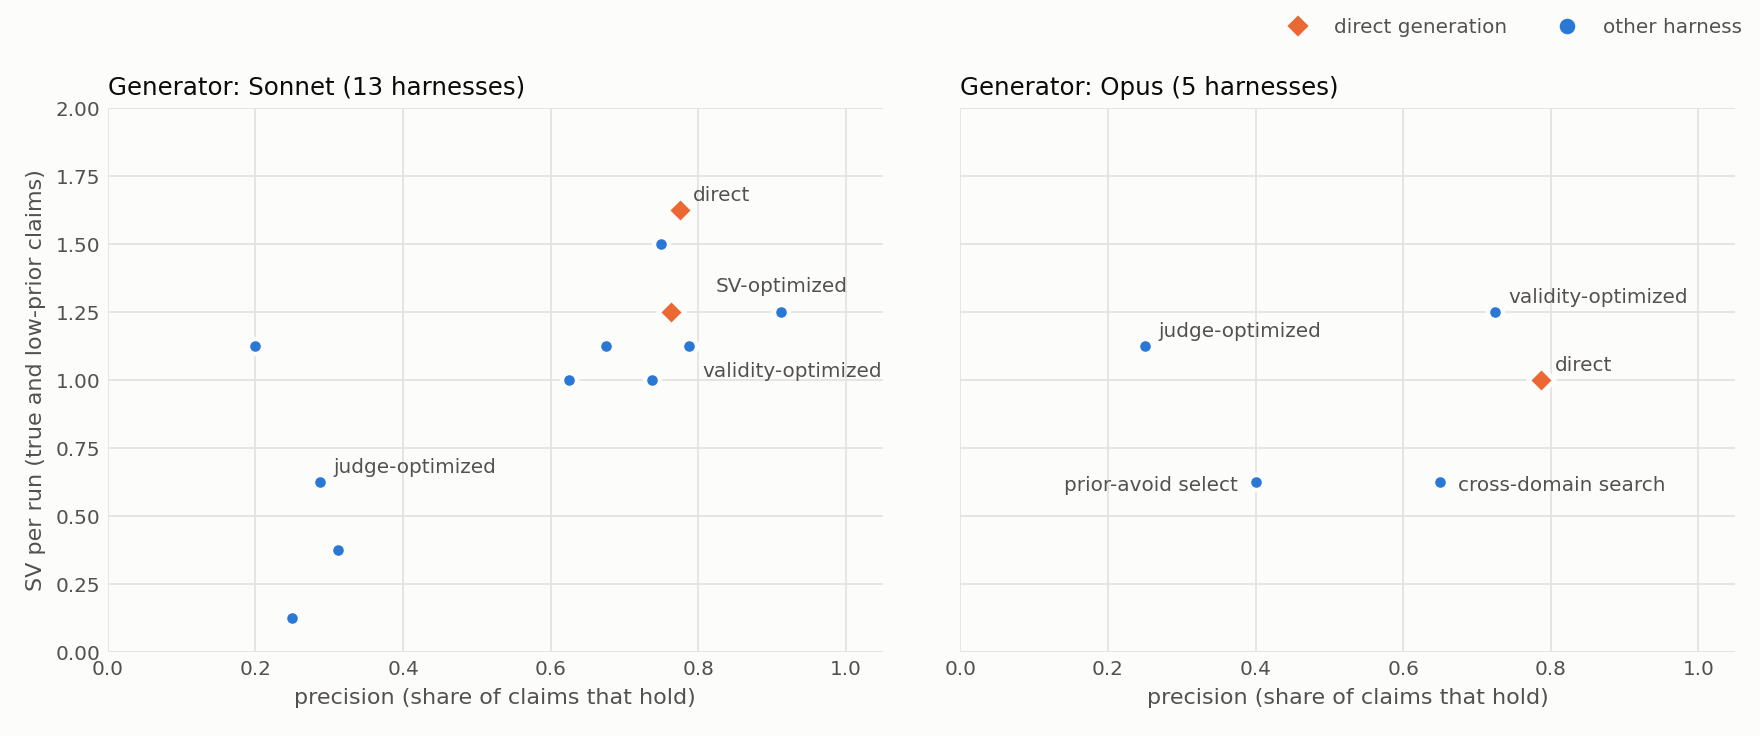
图:每个点是一个 harness,横轴是精度,纵轴是每次运行的 SV 条数。左图的两个橙色菱形分别是阶段 1 和阶段 2 的直接生成,同一个 harness,两批独立运行(1.25 和 1.62)。两批之间的差,本身就说明了 8 次运行的噪声有多大。
6.2 预注册判定
- D1:支持。
- Sonnet 有 11 个比较,Opus 有 4 个比较,Holm 校正后全部不显著(最小原始 p = .35);
- 最大的正差只有 +0.25 条/次。
- D2:不确定。 Sonnet 上 13 个 harness 的 ρ = 0.87(支持);Opus 上只有 5 个 harness,ρ = 0.40。
- D 总判定:未支持,因为 D2 不确定。
- A 在 Opus 上的复核:J 臂最终版同样让精度崩塌(0.79 → 0.25)、先验下降(67.8 → 44.3),但 SV 没有下降(1.00 → 1.12,不显著)。
6b. 阶段 4:测量旋钮("想"不行,"测"行不行)
动机:阶段 1 到 3 中,所有只改内部推理的干预都推不动 SV;前期 P1 中,只有外部测量能带来有精度的判断修正。所以这里检验:允许 harness 在提出假设前做少量真实实验,能否推动前沿。
设计(PREREG_s4.md):
- 一次测量:对一个父 cell 做一次编辑,返回 3 个数据集上的准确率变化。
- 测量用 NB201 的 test 划分,判真用 val 划分,两者不是同一组数字;
- 但表里的值是多种子均值,所以噪声比真实实验低。
- 实验臂:
- 随机测量 k = 20 / 100 / 400;
- 主动测量 k = 20 / 100:模型先设计实验,看到结果后再提假设;
- k = 0 是直接生成,复用已有的新运行。
- 生成模型是 Sonnet 和 Opus,每个臂跑 8 次全新运行,约 112 次调用。
结果:
| 臂 | Sonnet SV | 精度 | 先验 | Opus SV | 精度 | 先验 |
|---|---|---|---|---|---|---|
| k = 0 直接生成 | 1.62 | .78 | 62.7 | 1.00 | .79 | 67.8 |
| 随机 20 | 1.12 | .61 | 60.4 | 1.62 | .77 | 66.0 |
| 随机 100 | 1.75 | .51 | 56.3 | 1.75 | .72 | 60.2 |
| 随机 400 | 0.88 | .60 | 60.8 | 1.25 | .70 | 59.6 |
| 主动 20 | 1.00 | .45 | 54.5 | 0.62 | .57 | 61.7 |
| 主动 100 | 0.88 | .42 | 54.7 | 2.12 | .71 | 57.0 |
预注册判定:
- M1,测量推动前沿:不确定。
- Sonnet 上是否定:所有测量臂的 SV 都不超过直接生成 + 0.3,精度从 0.78 跌到 0.42–0.61。
- Opus 上方向支持,但校正后不显著:
- 主动 100 比直接生成多 1.12 条/次(原始 p = .012,Holm 校正后 .061);
- 随机 20 和随机 100 各多 0.62 和 0.75 条(原始 p ≈ .05,Holm 后 .19);
- 精度保持在 0.70–0.77。
- M2,剂量反应:不确定。 k = 400 并不比 k = 100 好,两个模型的 Spearman(k, SV) 都接近 0。
读法:
- 测量让两个模型都离开了先验,平均先验降低 2 到 11 分。
- 离开先验之后的结果取决于模型:Sonnet 把精度赔了进去,Opus 基本保住了精度,SV 也上升了。
- 这和前期 P1 的模型差异一致。在"根据测量重新考虑"的框架下,面对纯噪声级的测量,Sonnet 有 94% 改为跟随,Opus 只有 41%。
- 推测:测量是否有用,取决于模型能否按证据强度来折扣单次观测。
- 注意:Opus 的直接生成只有一批 8 次运行,值 1.00 可能偏低;Sonnet 两批独立的直接生成之间就差了 0.37。
6b.1 Opus 确认实验(预注册补充)
设计:三臂(不测量、随机 100、主动 100)各补 8 次全新运行,合并后每臂 16 次,只做 2 个比较。另外单独报告只用新一批运行的结果,作为独立重复。
| 臂 | 第一批 SV / 精度 | 新一批 SV / 精度 | 合并 16 次 SV / 精度 |
|---|---|---|---|
| 不测量(直接生成) | 1.00 / .79 | 2.00 / .81 | 1.50 / .80 |
| 随机 100 | 1.75 / .72 | 1.38 / .65 | 1.56 / .69 |
| 主动 100 | 2.12 / .71 | 2.12 / .71 | 2.12 / .71 |
判定:
- 合并 16 次(主分析):不确定。 主动 100 比直接生成多 0.62(p = .037,Holm .074);随机 100 只多 0.06。
- 只看新一批(独立重复):否定。 两臂都不超过直接生成 + 0.3。
- 结论:第一轮的效应主要来自对照组那一批偏低。同一个直接生成 harness,两批运行分别是 1.00 和 2.00。测量推动前沿:未确认。主动设计实验的臂很稳定,但它的优势需要更大样本才能判断。
6c. 阶段 5:加大样本量的确认实验
设计(PREREG_s5.md):
- 3 个臂:直接生成、judge 优化版(final_J)、主动设计 100 次测量(A-100);
- 每个生成模型 × 每个臂跑 24 次全新运行(rep 116–139),主分析只用这批新运行;
- Opus 的直接生成和 judge 优化版另打 judge 分;
- 每个差值附 90% bootstrap 置信区间;
- 事前计算的可检测最小效应约 0.73 条/次。
结果:
| 臂 | Sonnet SV | 精度 | 先验 | Opus SV | 精度 | 先验 | Opus judge |
|---|---|---|---|---|---|---|---|
| 直接生成 | 1.12 | .79 | 64.6 | 1.08 | .87 | 68.1 | 8.2 |
| judge 优化版 | 1.33 | .43 | 56.7 | 0.79 | .28 | 42.6 | 8.9 |
| 主动设计 100 次测量 | 1.17 | .45 | 55.3 | 2.12 | .75 | 55.3 | — |
预注册判定:
- A-prec(精度崩塌):支持。 精度差 Sonnet −0.36,Opus −0.59,都是 p < .001。
- A-judge(Opus 上 judge 分上升):支持。 +0.62,p < .001。
- A-SV(SV 下降):
- Sonnet 否定:+0.21,CI [−0.25, +0.71];
- Opus 不确定:−0.29,CI [−0.63, +0.08]。
- 阶段 2 里 Sonnet 的"1.62 → 0.62"没有重复出来。
- M(测量推动前沿):
- Opus 支持:+1.04 条/次,90% CI [+0.54, +1.58],Holm p = .003,精度 0.75 ≥ 0.8 × 0.87。
- Sonnet 否定:+0.04,CI [−0.29, +0.38],上界 < 0.5,即排除了 ≥ 0.5 条/次的提升;精度从 0.79 跌到 0.45。
读法:
- Opus 的主动测量臂在三批独立运行中都是 2.12(8、8、24 次);同期的直接生成三批分别是 1.00、2.00、1.08。
- 阶段 4 确认实验没能通过,是因为直接生成的第二批偏高(2.00)。用更大的新样本后,效应清楚地出现了。
- 成本:主动测量臂约 33k token/次,直接生成约 6k。按每 1k token 的 SV 算,直接生成仍然更划算;但绝对 SV 翻了一倍。
6d. 阶段 6:带噪声的测量
预注册见 experiments/harness/PREREG_s6.md。
- 设计:只用 Opus,rep 116–139。复用阶段 5 中 A-100 的实验设计,只替换返回给模型的测量值,所以与干净 A-100 可以逐 rep 配对比较。
- 三个噪声臂:
- N1:干净差值加高斯噪声,标准差为 √2 × (0.3, 0.6, 0.9) pp。这是假设的单种子标准差,约为典型效应的一半。
- N2:噪声加倍,约与典型效应相当。
- L:改用 12 个 epoch 训练的准确率差值。这是真实的低保真代理,在这些 probe 上与完整训练的符号一致率约 0.70。
- 72 次调用全部成功。
| 臂 | SV/次 | 精度 | vs BASE:SV 差 [90% CI],Holm p | 判定 | 配对 vs 干净 A-100:SV / 精度 |
|---|---|---|---|---|---|
| BASE | 1.08 | .87 | — | — | — |
| 干净 A-100 | 2.12 | .75 | — | — | — |
| N1 | 1.83 | .71 | +0.75 [+0.38, +1.17],.007 | 支持 | −0.29 [−0.71, +0.12] / −0.03 |
| N2 | 1.88 | .69 | +0.79 [+0.33, +1.25],.011 | inconclusive(精度约束) | −0.25 [−0.58, +0.08] / −0.05 |
| L | 2.21 | .65 | +1.13 [+0.71, +1.58],.001 | inconclusive(精度约束) | +0.08 [−0.42, +0.54] / −0.10 [−0.15, −0.04] |
读法:
- 现实噪声下,M 仍然成立。
- 但 SV 对测量质量几乎不敏感,测量质量只影响精度(.75 → .71 → .69 → .65)。
- 由此产生一个尚未排除的解释:SV 的提升主要来自"自己设计实验"这一步(结构化探索),而不是来自测量值。区分它需要"只设计不给结果"或"给打乱后的结果"的对照,这个对照还没有做。
6e. 阶段 7:打乱结果与只给设计的对照
预注册见 experiments/harness/PREREG_s7.md。
- 设计:只用 Opus,rep 116–139,与 A-100 用同一批 probe。
- 两个对照臂:
- S:测量值在 probe 之间整行打乱;
- D0:只列出 probe,不给数值。
- 48 次调用全部成功。
| 臂 | 给模型看的 | SV/次 | 精度 |
|---|---|---|---|
| BASE | 无 | 1.08 | .87 |
| D0 | 只有 probe 列表 | 1.83 | .79 |
| A 干净 | probe + 正确数值 | 2.12 | .75 |
| S | probe + 打乱的数值 | 1.42 | .58 |
预注册判定:
- A − S:+0.71 [+0.12, +1.33],Holm .072;
- A − D0:+0.29 [−0.17, +0.79],Holm .214;
- 两个都是 inconclusive。
读法:
- 只给 probe 列表时,SV 就比直接生成高 0.75(p = .003),约占测量提升(+1.04)的 70%,精度也比所有带数值的臂都高。
- 错误数值有害:打乱后,SV 回落到与直接生成无显著差别,精度降到 .58。
- 正确数值相对 D0 的增益不显著。
- 初读时,这像是在说 6b–6d 的效应主要来自"先逐个写出具体实验"这一步。但阶段 8(6f)把这一步做成真正的 harness 后,效应消失了,所以这个读法不成立。
- 注意:
- D0 vs BASE 不是本阶段的预注册主比较;
- D0 的 probe 是在"会拿到结果"的预期下设计的;
- 结论只覆盖 Opus 和 NB201。
6f. 阶段 8:只设计实验的 harness
预注册见 experiments/harness/PREREG_s8.md。
- 设计(P-100):明确告诉模型拿不到任何结果,让它先写出 100 个实验,再看着自己的实验列表提假设。
- Opus 和 Sonnet 各 24 次,96 次调用全部成功。
| 模型 | BASE | P-100 | D0(阶段 7) | A-100 |
|---|---|---|---|---|
| Opus SV / 精度 | 1.08 / .87 | 1.25 / .69 | 1.83 / .79 | 2.12 / .75 |
| Sonnet SV / 精度 | 1.12 / .79 | 1.21 / .70 | — | 1.17 / .45 |
预注册判定(P-100 − BASE):
- Opus:+0.17 [−0.21, +0.54],inconclusive(CI 上界只比否定线高 0.04);
- Sonnet:+0.08 [−0.29, +0.42],否定。
读法:
- "设计实验本身就是 harness"不成立。P-100 是又一种只改内部推理的 harness,与论点 D 一致:推不动 SV,只降低精度。
- 阶段 7 的 D0 与 P-100 只差"设计时以为会拿到结果"。D0 的 1.83 要么来自"为测量而设计"带来的针对性,要么部分是批次波动(Opus 直接生成三批分别为 1.00、2.00、1.08)。
- 最稳的事实:
- Opus 拿到测量值的四个臂(干净、N1、N2、L,各 24 次)的 SV 都在 1.8–2.2;
- 打乱数值后为 1.42;
- 不涉及测量的 BASE 和 P-100 在 1.1–1.25。
- 因此 M 的表述改为:对 Opus,测量有用;测量质量主要影响精度,不太影响 SV;测量内容的独立贡献(A − S = +0.71,Holm .072)还没过预注册门槛。
6g. 阶段 9:第二个公开空间(HPOBench 表格 MLP)
预注册见 experiments/harness/PREREG_s9.md,结果见 RESULT_s9.md。
- 空间:
- HPOBench 的表格 MLP 基准,5 个超参数(alpha、batch_size、depth、learning_rate_init、width),30,000 个配置,每个配置 5 个种子;
- 3 个 OpenML 数据集:phoneme、segment、vehicle;
- 主张为"某超参数上调(或下调)一档的效果,在另一超参数处于低/中/高档时更高(或更低)",共 148 个格子、296 条主张,41 条为真(τ = 0.5 pp),随机精度 .139。
- 测量:每个数据集随机取 1 个训练种子,返回单次训练的 test 差值;与 5 种子平均 val 差值的符号一致率为 0.70。
- J harness:在 NB201 上为 judge 进化出来,原样迁移到本空间。
- 调用:15 次先验调用加约 432 次生成和 judge 调用。Opus 有 2 次设计调用遇到 CLI 超时,重跑后补齐到每臂 n = 24。
| 模型 | 臂 | SV/次 | 精度 | judge |
|---|---|---|---|---|
| Sonnet | BASE | 1.83 | .82 | 8.1 |
| Sonnet | J | 2.21 | .43 | 9.2 |
| Sonnet | A-100 | 2.71 | .83 | — |
| Opus | BASE | 4.17 | .90 | 8.2 |
| Opus | J | 2.46 | .42 | 10.0 |
| Opus | A-100 | 4.67 | .89 | — |
预注册判定:
- M:Sonnet 支持(+0.88 [+0.46, +1.29],Holm .002);Opus 支持(+0.50 [+0.17, +0.83],Holm .019)。
- A-prec、A-judge:两个模型都支持。
- A-SV:Opus 支持(−1.71),Sonnet 否定(+0.38)。
读法:
- A 在第二个空间上完整复现,而且是用 NB201 上进化出的 harness 迁移过来的。
- M 在两个模型上都成立,而且测量带有真实噪声。Sonnet 在 NB201 上的失败没有在这里出现。所以模型差异更可能与"模型对该空间的先验有多强、多准"有关,而不是 Sonnet 普遍不会用证据。这一点是推测,未验证。
6h. 阶段 11:Sonnet × NB201 失败的因果检验
动机:事后分解(7.2)把失败归到三层:空间(冲突证据多为假象)、呈现方式(NB201 的测量被描述为真实测量)、模型(Sonnet 主动选择冲突主张)。其中"呈现方式"和空间完全混在一起,所以本阶段用 prompt 操纵来检验(PREREG_s11.md)。
设计:
- 复用 Sonnet 自己设计的探针,只改"提出假设"那一次调用;与同一 rep 的原运行配对比较。
- NB201 用 rep 117–139(rep 116 的探针全部解析失败,预先排除);HPOBench 用 rep 200–223。
- 三个臂:
- F:NB201 加一句真实说明:"每个结果只来自一个父 cell,单个结果对整体是弱证据";
- G:NB201 要求"只提出实验支持、且你自己的知识也认为合理的假设";
- H:HPOBench 去掉"单次训练种子"的说明。
- 共 70 次 Sonnet 调用。
| 臂 | 精度 原 → 新 | 差 [90% CI],Holm p | SV 原 → 新 | 冲突处站在证据一边 | 判定 |
|---|---|---|---|---|---|
| F 弱证据说明(NB201) | .44 → .49 | +.04 [−.00, +.09],.096 | 1.17 → 1.26 | .91 → .95 | inconclusive |
| G 先验一致性筛选(NB201) | .44 → .60 | +.15 [+.09, +.22],.001 | 1.17 → 1.13 | .91 → .95 | 支持(刚过门槛) |
| H 去掉单次种子说明(HPOBench) | .83 → .77 | −.06 [−.10, −.03],.007 | 2.71 → 2.46 | .61 → .80 | inconclusive(方向如预期,幅度未达 −.10) |
读法:
- Sonnet 会对测量噪声打折扣:写明"单次种子"时,它在冲突时较少跟随证据(H 臂中去掉说明后从 .61 升到 .80)。
- 但它不会对样本代表性打折扣:写明"单个父 cell、推广性弱"几乎没有效果(F 臂 .91 → .95)。NB201 的测量是"精确但不具代表性"的,正落在这个盲区。
- "先验一致性筛选"能缓解失败:精度提高 .15,SV 不受损。但精度仍低于直接生成(.79),只是部分缓解。它已作为
--prior-check选项加入 ideagen。 - 预期中的两条(F 会降低对证据的信任;G 会把冲突主张占比降到 .25 以下)没有实现:G 的冲突占比只降到 .30。
6i. 阶段 12:三分类先验补测(M 在更正后不成立)
起因:一份外部审阅材料指出,先验问卷只问 P(HIGHER),LOWER 主张的先验取 100 − P(HIGHER),这就把"无交互"的概率也算给了 LOWER。我们在缓存上逐条核实,数字全部属实:
- 面板的 P(HIGHER) 均值很低:NB201 上为 20.6 / 25.3 / 45.6,HPOBench 上为 21.6 / 27.5 / 40.2。所以 LOWER 主张的"先验"几乎总是 ≥ 50。
- SV 候选(为真且留一先验 < 50)中 LOWER 占 0%,4 个单元都是;而真主张中 LOWER 占 57%(NB201)和 54%(HPOBench)。
- HPOBench 上 k ≠ j 的"上调一步"与"下调一步"主张两两等价(60 对,效应精确相反)。按补码规则,同一命题的两种写法拿到相反的标签:用 Haiku 打分时 60/60 对,Sonnet 55/60 对,Opus 41/60 对。
- 测量臂提高了 HIGHER 主张的占比:NB201 · Opus 从 .27 升到 .53,HPOBench · Sonnet 从 .41 升到 .55。如果所有真 LOWER 主张都算意外,原来成立的 3 个单元的 M 全部变号:−1.25、−0.46、−0.17。
设计(PREREG_s12.md,写在任何调用之前):
- 请原面板对两个空间的全部格子给出 P(更高)、P(更低)、P(无一致且有实际意义的差异),共 102 次调用,全部成功。
- 用新先验对全部缓存运行重新计分,不需要生成调用。
- 主要指标 SV3:主张为真,且留一面板对"所述方向"的概率 < 50。HPOBench 的等价写法先合并再计分。
三分类先验长什么样:
- 三位面板成员都认为大多数格子没有交互:P(无交互) 平均为 Haiku 68–70,Sonnet 68–69,Opus 47–53。
- 新 P(更高) 与旧 P(HIGHER) 的相关系数为 .67 / .70。
- HPOBench 等价写法的评分差中位数为 3 分。
预注册判定:
- V1 支持:真 LOWER 主张中,有 92%(NB201)和 95%(HPOBench,21/22)的留一 P(更低) < 50。原指标漏记了这些意外发现。
- M3:
| 单元 | SV3:BASE → A-100 | 差 [90% CI] | 精度 | 判定 |
|---|---|---|---|---|
| NB201 · Sonnet | 3.54 → 2.62 | −0.92 [−1.42, −0.42] | .79 → .45 | 否定 |
| NB201 · Opus | 6.96 → 6.21 | −0.75 [−1.42, −0.04] | .87 → .75 | 否定 |
| HPOBench · Sonnet | 5.33 → 3.42 | −1.92 [−2.33, −1.50] | .81 → .82 | 否定 |
| HPOBench · Opus | 5.38 → 5.42 | +0.04 [−0.50, +0.62] | .90 → .89 | inconclusive |
- 混合先验(HIGHER 用旧评分,LOWER 用新评分)给出同样的方向:−0.42、−0.88、−1.12、−0.04。所以变化来自补测了 LOWER 的先验,而不是三分类格式改变了 HIGHER 的评分。
事后分析(描述性):
- 阈值 50 不区分"意外":三分类下,面板对绝大多数有向主张给 < 50,SV3 接近"为真的条数"。原指标对 HIGHER 主张其实也是这样:85 条真 HIGHER 主张中有 67 条可计为 SV。
- 不依赖阈值的 R:R = Σ(真值 − π),π 是把面板先验对真值做逻辑校准后的概率,协变量为 logit P、阶、方向。
| 单元 | A-100 − BASE(p) | J − BASE |
|---|---|---|
| NB201 · Sonnet | −0.57(.96) | +0.88 |
| NB201 · Opus | +0.19(.32) | −2.24(p < .001) |
| HPOBench · Sonnet | +0.11(.31) | −0.89(p < .001) |
| HPOBench · Opus | +0.42(.06) | −1.69(p < .001) |
用旧先验做同样的校准,结论相同。
- 严格阈值(只算面板 P < 20 / 25 / 33 的真主张):Opus 加测量后,HPOBench 上多 +0.92 / +0.92 / +0.79(p ≤ .01),NB201 上多 +0.12 / +0.46 / +1.00。阈值是事后选的,只能算线索。
读法:
- 原来的 M 是指标的产物。测量把主张推向唯一能被原指标记为"意外"的方向。
- A 更强:judge harness 的主张仍比校准后的面板预期更常为真,但超出的幅度比直接生成少 0.9–2.2 条/次(R 在 3/4 单元显著下降;NB201 · Sonnet 例外,R 上升)。
- D 基本不变(
s12_d.py,事后):19 个内部推理 harness 在 SV3 上经 Holm 校正后无一超过直接生成。R 上有两个 Sonnet 例外:以 SV 为目标优化出的 harness(+1.98,Holm .02,8 次运行)和 judge harness(+0.88,Holm .04)。两者都以精度为代价,把 Sonnet 推向面板认为不太可能的主张。Opus 没有例外。 - 阶段 11 的结论基于精度,不受影响。冲突分析与"站在证据一边"用三分类先验重算后(
post_conflict3.py、s11_three_way.py),模式不变,而且更清楚:- NB201 上,Sonnet 有 37% 的主张提在冲突处,Opus 只有 5%;这些主张的精度分别是 .24 和 .17。
- 在冲突处,NB201 上两个模型 83–92% 跟随证据,HPOBench 上只有 10–24%。
- 去掉"单次种子"的说明后,HPOBench 上跟随证据的比例从 .11 升到 .42;加"单个父 cell"提示后,NB201 上从 .91 变为 .89;先验一致性筛选把冲突主张占比从 .37 降到 .26。
- 外部材料还报告"测量提高了信息信用",但它用的是旧补码先验,而且只统计 p < 50 的主张,同样不成立。
脚本:experiments/harness/s12.py(预注册分析)、s12_post.py(阈值扫描与 R)、s12_rmulti.py(多协变量校准的 R);三分类先验缓存在 out2/prior3_*.json。
7. 讨论
7.1 可以写下的结论
LLM judge 不应作为 ideation harness 的优化目标(A)。
- 2 个公开空间 × 2 个生成模型,judge 分全部上升(+0.6 到 +1.8),精度全部崩塌(−0.36 到 −0.59);私有空间上(Sonnet)精度降到 0.03。在 NB201 上为 judge 进化出的 harness,迁移到 HPOBench 后同样如此。
- 机制看得很清楚:judge 把"低先验"当成"新颖",而优化器学会了直接禁止那些最常为真的主张类型。
- "SV 也下降"只部分成立:NB201 大样本下没有重复;HPOBench 上 Opus 显著下降(4.17 → 2.46),Sonnet 没有。judge 的核心问题是"用大量错误主张换来更高的分数";当模型的先验本来就准时,还会损失真发现。
只以"为真"为目标,会得到安全但不更有用的 harness(P2):先验升高,主张收窄,精度并没有提高。这在 harness 层面复现了 Si et al. 在权重训练上观察到的"求稳"。
在本研究覆盖的 harness 范围里,没有一个能显著增加真且意外的发现(D1,阶段 8 补充)。
- 范围包括:结构旋钮、三种 fitness 的进化结果、手写的先验规避、跨领域检索,以及"先写出 100 个实验、但不给结果"(阶段 8);
- "直接生成"便宜 3 到 7 倍,却始终在前沿上或接近前沿。
(已被阶段 12 推翻,保留原文作记录)外部测量是唯一推动了前沿的干预(阶段 5–9),4 种模型 × 空间组合中有 3 种显著。 更正后的结论见第 5、6 条。
- NB201、Opus:
- SV 翻倍(1.08 → 2.12,CI [+0.54, +1.58]),精度基本保住;
- 在现实噪声下仍成立(阶段 6);
- 测量越不准,精度越低,但 SV 基本不变。
- HPOBench:测量是真实的单次训练结果(符号一致率 0.70)。Sonnet +0.88、Opus +0.50,精度都不降。
- NB201、Sonnet:精度崩塌,SV 不变。这是唯一的失败组合。前期 P1 中 Sonnet 在追问下更容易跟随噪声,这可能是原因之一;但它在 HPOBench 上用同样嘈杂的测量没有出问题,所以单靠"模型不会用证据"解释不了。
- 单独"设计实验"不起作用(阶段 8);打乱结果会伤害 SV 和精度(阶段 7)。测量值本身有贡献,但它的独立贡献(+0.71)还没过 Holm 门槛。
- 对 autoresearch 一类系统的含义:
- 把预算从更多角色和反思,转到廉价的真实测量上,哪怕是单次、带噪声的测量;
- 在模型很熟、先验很准的领域里,要监控测量是否在把模型从正确的先验上拉走(看精度)。
- NB201、Opus:
"意外度"指标必须对方向不变(阶段 12,V1 支持)。
- 补码先验把"无效应"算进 LOWER:SV 候选中 LOWER 占 0%,真主张中 LOWER 占 54–57%;HPOBench 上 60 对等价命题的两种措辞,在 41–60 对里拿到相反标签。
- 测量臂恰好把主张推向 HIGHER(NB201 · Opus .27 → .53),于是在原指标上表现为"增益"。
- 三分类问法下,两种措辞的评分差中位数只有 3 分,而真 LOWER 主张中有 92–95% 是面板没有预料到的。
更正后,测量没有增加真且意外的发现(阶段 12,M3:3 个单元否定,1 个 inconclusive)。
- 预注册 SV3 差:NB Sonnet −0.92,NB Opus −0.75,HPO Sonnet −1.92,HPO Opus +0.04。
- 不依赖阈值的 R(超出校准面板预期的为真条数)上,测量在任何单元都没有显著提升(最大 +0.42,p = .06)。
- 事后线索:Opus 在严格阈值(面板 P < 20–33)下每次多约 1 条,需要新运行确认。
- 同时,A 更强了:在 R 上,judge harness 在 4 个单元中的 3 个显著低于 BASE(p < .001)。它的 R 本身仍为正,即主张仍比校准面板的预期更常为真,只是超出的部分比直接生成少 0.9–2.2 条/次。
7.2 为什么只改内部推理推不动,测量却可以(推测,未验证;阶段 12 之后"测量可以"这一前提已不成立,本节保留作记录)
- 信号太稀:直接生成每次约 1 条 SV,标准差 0.8。6 次运行的标准误约 0.33,与候选之间的真实差距同一个量级,优化器主要在追噪声。证据是:被采纳的 harness 在新运行上全部回落。
- 共享先验:
- 生成模型本身也是先验的一部分,"先估计别人怎么想,再避开"实际上做不到:SV2 的规则反而提高了精度和先验;
- 要跳出共享先验,可能需要外部信息,比如实测数据或真正的实验,而不是更多的内部推理。这与前期 P1 的结论一致:只有测量带来有精度的推翻。阶段 5–9 支持这一点:4 种模型 × 空间组合中有 3 种成立。阶段 8 也说明,"把实验写出来"这种内部推理本身不够,需要真的拿到观测。唯一的失败(Sonnet × NB201)出现在模型先验最强、最准的地方。我们推测,测量的价值取决于它与模型先验的相对可靠性;在先验已经很准时,带噪声的观测可能把模型拉离正确答案。这一点还需要用更多模型和空间检验。
- 事后检查(2026-10-21)推翻了这个推测:
- 用面板先验给有方向的主张按真假排序,AUC 分别是:NB201 上 Haiku .53、Sonnet .64、Opus .86;HPOBench 上 .58、.64、.81。
- Sonnet 在 NB201 上的先验并不准,先验最准的 Opus 反而从测量中受益最多。
- 而"Sonnet 不会按证据强度折扣观测"的解释,又与它在 HPOBench 上受益相矛盾。
- 结论:先验准确度和"不会权衡证据"这两种解释都不成立。
- 事后分析找到了失败机制(2026-10-21):比较每条假设与生成模型自己在面板里的盲打分。
- Sonnet × NB201 测量后,37% 的假设与自己的先验相反(直接生成时为 14%),这些假设只有 24% 为真。其他三个组合中这一比例只有 8%–12%。
- Sonnet 的 240 条假设中,有 42 条重复两个错误模式,全部为假:"把 skip 或 avg_pool 换成 conv3x3 增益更大"。它自己的实验样本支持前者:skip→conv3x3 平均 +7.95pp。但 NB201 的增益分布重尾:少数没有卷积的退化 cell 单次修改就能提升超过 15pp,同一量在不同子样本上的均值在 +3.8 到 +6.0pp 之间波动。
- 结论:测量有用,是在模型用它从先验允许的主张里做选择时;测量有害,是在模型用少数醒目的实验推翻自己的先验时。
- 为什么只有 NB201 会触发 Sonnet 推翻先验,仍未确定。我们检查了每条主张背后的实验数、受控对照比例、父 cell 的典型性、证据与真值的一致率(四个组合都在 .75–.85)以及实验数值大小,没有一项能区分失败组合。
- 分析脚本:
experiments/harness/post_override.py(只读缓存)。
- 三层分解(2026-10-21,事后):对每条"先测量再提出"的假设,看模型自己的实验证据和它自己的先验是否一致。
- 空间层面:NB201 上,在"证据与先验冲突"处提出的主张,只有 29%(Sonnet)和 25%(Opus)对应真实效应,精度为 .25 和 .22;HPOBench 上同类主张的精度是 .51 和 .88。NB201 上单个父 cell 的对比常常只反映这个 cell 的特殊性。
- 呈现方式:提出冲突主张时,两个模型在 NB201 上 91% 站在证据一边(prompt 把测量描述为真实测量),在 HPOBench 上约 60%(prompt 写明单次训练种子)。这一层和空间混在一起,尚未分离。
- 模型层面:Sonnet 有 96 条主张(42%)提在冲突处,Opus 只有 36 条(15%)。Opus 主要提出先验和证据都支持的主张,这些主张的精度是 .84;Sonnet 的同类主张精度只有 .58,与它较弱的先验一致。
- 失败需要三者同时出现:冲突证据多为假象、呈现方式让人信任证据、生成模型主动选择冲突主张。
- 脚本:
experiments/harness/post_conflict.py(需要原始表格)。
- 与 AIDE²(2609.26457)的关系:
- AIDE² 表明,当外层有私有、可执行的真值分数时,研究 agent 的 harness 可以递归自改进;
- 我们的 J 臂相当于把这个分数换成 LLM judge,结果是 judge 分上升、精度崩塌;
- 两者合起来说明,自改进的上限取决于选择信号与真值的距离。
- ideation 没有现成的私有分数,唯一的来源是去做实验,这正是 M 所检验的。
- 两篇在"harness 进化是否有效"上结论相反(AIDE² 有效,我们的 D 无效)。一个与两边证据都相容的解释是信号类型不同:可执行的真值分数,对比 judge 分或稀疏的有效性信号。这一点尚未直接检验。
7.3 新颖度自评
| 论点 | 证据强度 | 新颖度(1–5) | 理由 |
|---|---|---|---|
| A:judge 作为 fitness 会 Goodhart(judge 分升、精度崩) | 强(预注册,2 个公开空间 + 1 个私有空间,两生成模型,大样本确认,跨空间迁移) | 3–3.5 | 奖励过度优化早为人知;新的是在 ideation harness 的优化闭环里、用实测真值直接展示,并给出机制(禁止常真的主张类型);"SV 下降"未重复 |
| P2:只看有效性会求稳 | 中 | 2 | Si et al. 已在权重训练上报告过 |
| D:只改内部推理的 harness 推不动"真且意外"的前沿 | D1 强,D2 不确定 | 3.5 | 用实测真值在 19 个 harness(两个生成模型)上系统检验,包括"只设计实验",我们没找到先例;harness 的训练只在 NB201 上做,HPOBench 上只检验了迁移来的 J harness |
| M:少量真实(可带噪声)测量能推动前沿 | 中强(4 种模型 × 空间组合中 3 种支持,含真实单种子噪声;唯一失败为 Sonnet × NB201;内容的独立贡献未过门槛) | 3.5–4 | 用实测真值证明"测量 > 内部推理",并给出失败条件的线索(模型先验很准时);需要非 Claude 模型 |
8. 局限
- 检验效力:每臂 8 次运行时,同一 harness 两批之间可以相差 0.37(Sonnet)到 1.0(Opus)条 SV/次,可检测的最小效应约为 1 条/次。所有"推不动"的结论(D1、M1)只能排除更大的提升。
- 空间:
- harness 训练只在 NB201 上做,模型对它很熟(直接生成的精度就有 0.78);HPOBench(阶段 9)只检验了 BASE、迁移来的 J 和 A-100 三个臂,D 的其余 harness 没有在第二个空间上检验;
- 私有空间上 SV 太稀(每次 0–0.12 条),只能做描述性检查。
- 优化预算:每个臂只有 3 轮 × 3 个候选 × 6 次运行,不能排除"更大的搜索就能推动前沿"。
- 评测规模:除阶段 5 的 3 个关键臂(每臂 24 次)外,每个 harness 只有 8 次新运行。
- 测量的真实性:主实验的测量是多种子均值。阶段 6 加入了合成噪声和 12-epoch 代理,SV 的提升仍然存在;但噪声大小是假设的。阶段 7 中只给设计、不给结果的 D0 也很高(1.83),但阶段 8 中明知没有结果的设计 harness 不行(1.25),所以 D0 的高分要么来自"为测量而设计",要么是批次波动;测量内容的独立贡献尚未通过预注册门槛。
- A-100 的选择:这一臂是看过阶段 4 的结果后选进阶段 5 的;阶段 5 用的是事先固定的全新运行,但"选哪一臂来确认"这一步有选择偏差。
- 自我偏好:judge 和 proposer 都是 Opus,J 臂可能存在自我偏好。
- 先验来源:先验面板只有 3 个 Claude 系模型,"共享先验"在这里是 Claude 家族的先验。前期 Q1 里加入 GPT 系模型时,看到了类似的高一致性,但那份数据没有用于本研究的 SV 定义。
- 实现 bug:不变式 bug 影响了阶段 2 的 SV 臂和 V 臂,阶段 3 已修复并重跑 SV 臂;V 臂没有重跑。
- 事后提出的论点:D 是看到阶段 2 结果之后提出的。它的检验(阶段 3)是预注册的,但"提出 D"这一步本身存在选择偏差。
9. 复现
pip install -r requirements.txt            # numpy, scipy (matplotlib for the figure)
cd experiments/harness
python3 s1_analyze.py                      # 阶段 1 判定(读取 out/ 缓存)
python3 s2_analyze.py                      # 阶段 2 判定(读取 out2/ 缓存,仅 NB201 部分)
python3 s3_analyze.py                      # 阶段 3 判定
python3 s4.py analyze && python3 s4.py confirm-analyze   # 阶段 4 及其确认
python3 s5.py analyze                      # 阶段 5 大样本确认
python3 s6.py analyze                      # 阶段 6 带噪声测量
python3 s7.py analyze                      # 阶段 7 打乱结果 / 只给设计对照
python3 s8.py analyze                      # 阶段 8 只设计实验的 harness
python3 s9.py analyze                      # 阶段 9 第二个公开空间(读取 fc_space.json,无需原始表)
python3 ../../figures/make_frontier.py # 重新生成图- 所有 LLM 调用都按内容缓存在
out/和out2/里,上面的分析不需要任何 API 调用。 - 重新运行生成需要
claudeCLI(订阅版即可)。对于没有缓存的检索查询,还需要一个检索器(LITSEARCH环境变量)。 nb_space.json是从 NAS-Bench-201 派生的 870 个格子统计。重建它需要一个 NB201 表格加载器(NB201_LOADER)。
10. 成本
| 阶段 | 订阅 CLI 调用(成功的调用;重试未计) |
|---|---|
| 阶段 1(先验 87 + 运行约 264 + judge 72) | 约 425 |
| 阶段 2 和 3(运行步骤、proposer 12、judge 116) | 约 1,000 |
| 阶段 4(测量旋钮,80 次运行) | 约 112 |
| 阶段 4 确认实验(Opus,24 次运行) | 32 |
| 阶段 5 大样本确认(144 次运行) | 约 384 |
| 阶段 6 带噪声测量(72 次运行) | 72 |
| 阶段 7 对照(48 次运行) | 48 |
| 阶段 8 只设计实验(48 次运行,每次 2 次调用) | 96 |
| 阶段 9 第二个公开空间(先验 15 + 144 次运行与 judge) | 约 447 |
| 合计 | 约 2,640 |
附录:文件索引
| 文件 | 内容 |
|---|---|
experiments/harness/PREREG_s1.md / RESULT_s1.md |
阶段 1 预注册与结果 |
experiments/harness/PREREG_s2.md / RESULT_s2.md |
阶段 2 预注册与结果 |
experiments/harness/PREREG_s3.md / RESULT_s3.md |
阶段 3 预注册与结果 |
experiments/harness/s1.py、s2.py |
运行器与优化器 |
experiments/harness/out2/train_*.json |
每个臂每一轮的候选、得分和 proposer 的理由 |
experiments/harness/out2/final.json、fresh_SV2.json、frontier_opus.json |
新运行的逐次结果 |
experiments/harness/PREREG_s5.md / RESULT_s5.md / s5.py |
阶段 5(大样本确认)预注册、结果、运行与分析 |
experiments/harness/PREREG_s4.md / RESULT_s4.md / s4.py |
阶段 4(测量旋钮)预注册、结果、运行与分析;out2/run_m*.json 是逐次运行,含每次的测量列表 |