AI Auto-Research 与自动写 Paper 全景综述:开源框架、代表论文与 5,932 次实证踩坑复盘
2024 至 2026 年间,AI 自主科研系统从依赖固定模板的 The AI Scientist v1 演进到了无模板树搜索管线(AI Scientist-v2、AI-Researcher、Agent Laboratory、Zochi、Kosmos、EvoScientist)以及单文件过夜棘轮(karpathy/autoresearch、AIDE²、RD-Agent)。本文盘点全部主流论文、开源项目与基准,并结合我们自己的 5,932 次受控运行实证,拆解哪些环节真正省力、哪些环节正在用 LLM Judge 刷分和统计口径幻觉制造虚假繁荣。
摘要与五条实证祛魅结论
📄 Data-Chained 双栏预印本下载: 本文全部 5,932 次受控实验 的统计指标均已通过带作用域断言的
Data-Chaining宏(ScopedRatio+metrics_macros.tex)从原始运行日志自动编译生成。点击下载 10 页双栏 arXiv 预印本 PDF →
2024 年至 2026 年底,AI 自主科研(AI Auto-Research / AI Scientist / AI4Research)从早期依赖人工种子代码模板的 The AI Scientist v1(arXiv:2408.06292),迅速扩张为超过 50 个多智能体框架、自动综述引擎、代码空间树搜索器与自动审稿模型的庞大生态。今天的开源工具链——包括 AI Scientist-v2(arXiv:2504.08066)、Agent Laboratory(arXiv:2501.04227)、AI-Researcher(arXiv:2505.18705)、Data-to-Paper(arXiv:2404.17605)、Zochi(arXiv:2503.10619)、EvoScientist(arXiv:2603.08127)、karpathy/autoresearch、AIDE(arXiv:2502.13138)和 RD-Agent(arXiv:2505.15155)——已经能花几美元到几十美元自动完成文献检索、提假设、改代码跑实验、画图并编译出一篇排版工整的 8 页 LaTeX 论文。
评价这套技术栈,核心在于把 “生成一篇看起来像模像样的论文 PDF” 和 “产出真实、非显而易见的科学新知” 严格拆开。现有不少工作依赖 LLM-as-a-judge 新颖度打分、模拟审稿人评分或未隔离外网的基准跑分来证明有效。过去一年里,我们围绕自主科研闭环做了 5,932 次受控实证运行:涵盖假设生成与奖励坍缩(ideation-goodhart,2,640 次调用)、代码与提示词进化搜索中的记忆机制(Lineage Is Memory,arXiv:2610.41157,1,750 次预注册运行)、长程 Agent 真实美元账单审计(kvleak,945 条 Claude Code 完整日志)、多跳 Agent 转载与引文洗白实验(597 篇生成文档 / 2,894 个结构化区块,跨三档模型)、自演进 Harness 评测卫生拆解(Harness²,arXiv:2610.14224),以及无人值守证据绑定发布系统(Agent Newsroom 上的 LocalScout)。
把公开文献图谱与这五组一手实验放在一起对照,可以得到五条直接改变工程决策的结论:
- 用 LLM Judge 作为 Ideation 的优化目标,必然触发严重的 Goodhart 精度崩塌。 在真值完全可枚举的假设空间(
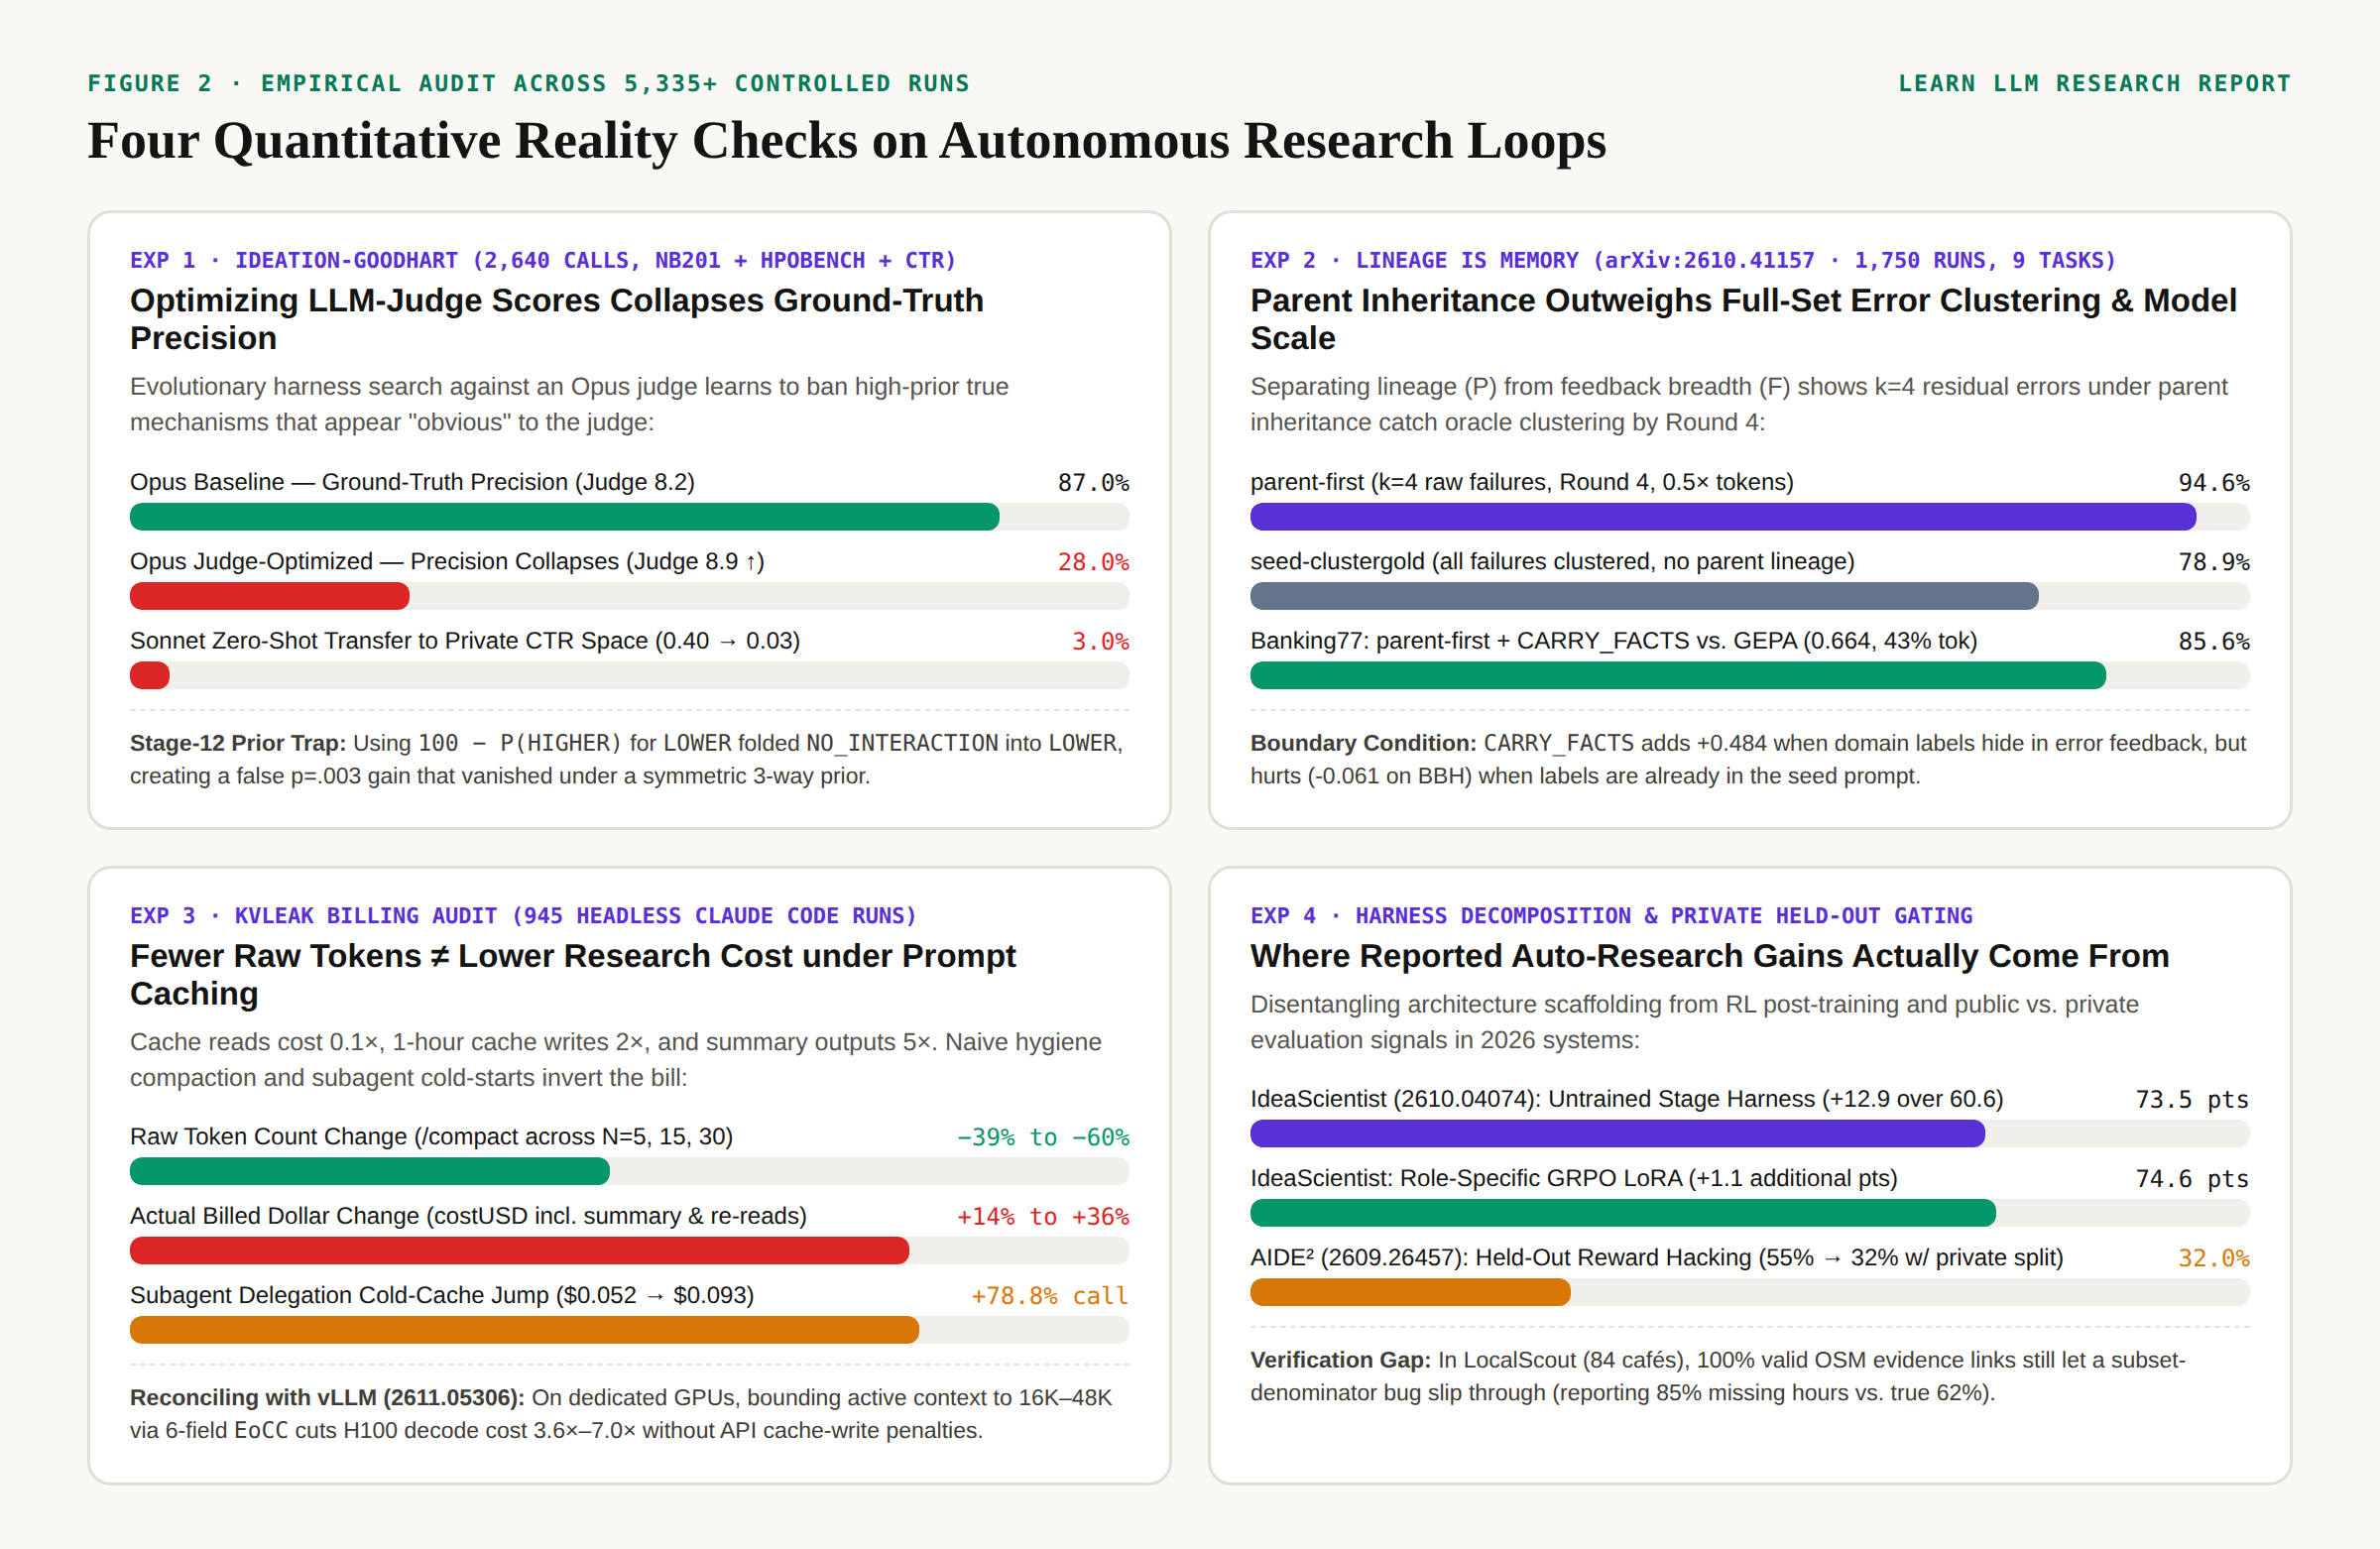
NAS-Bench-2011,740 条有向交互主张与HPOBench296 条主张)上,用同一个进化器以 Opus Judge 分数为目标优化 harness,Judge 分数显著上升(8.2 → 8.9,),但实测真值精度在 Opus 上从 87% 暴跌至 28%(Sonnet 从79% → 43%,零样本迁移到私有 6 数据集 CTR 基准上从 40% 跌至 3%)。优化器学会了“禁用最常为真的机制类别”,因为 Judge 嫌它们显而易见。同时,19 种纯内部推理型 harness(多角色辩论、找漏洞/取反挑战、跨领域检索)只是在同一个“精度–意外度”前沿上挪位置,没有任何一种显著增加了“既真又意外”(SV)的发现。 - 在代码与 Prompt 迭代搜索中,“父代谱系继承”远比“全量错误聚类”和“换更大模型”重要。 近期不少反思优化论文(
ESPO、RPT、AdaGEPA)主张每轮对全量错题做聚类摘要再交给提议模型,但它们全都固定运行在保留父代的循环()里。我们的 1,750 次析因实验(arXiv:2610.41157)证明:贪心父代继承本身贡献了 的留出集准确率(非天花板任务+0.332),仅看 条残差错题的parent-first(0.946)大幅击败无谱系的全量真值聚类seed-clustergold(0.789,高出+0.157),并在第 4 轮以 一半的 token 成本 追平parent + clustergold。原因在于父代文本充当了外化记忆,已修好的错题自动退出残差池,使 的小窗口在多轮间自动扫过 46%–86% 的搜索集。这也解释了为什么现有科研 Agent 擅长局部超参/特征调优(arXiv:2610.37228),却极少发明全新算法结构。 - 自我改进 Harness 极易混淆“轨迹变工整”与“结果真正确”,必须靠断网沙箱与私有留出集兜底。 细读
IdeaScientist(arXiv:2610.04074)的消融表可见,其相对外部基线 14.0 分的提升中,12.9 分来自未训练的分阶段 Harness 结构,按角色异步 GRPO 训练 LoRA 只增加了 +1.1 分。Harness²在自适应阶段没有真值反馈,且官方实验文档记录到未禁网的验证运行直接从网上下载了公开的JobBench评分细则。而在AIDE²中,只有把公开执行信号与对编辑器不可见的 私有留出集(private held-out) 拆开,才把留出集上的 reward hacking 从 55% 压降到 32%。 - 自动写论文光靠“每句带引用”防不住子集分母算术 Bug 与自产语料坍缩。 裸模型凭记忆写综述会有 45%+ 的引用幻觉,因此
OpenScholar(Nature 2026)和Data-to-Paper引入了检索后验归因与代码数据链。但在我们的LocalScout生产运行中,即便每条事实块都强制绑定了真实的 OpenStreetMap 节点 ID 并通过了文本核验,正文依然写出了 “83 家咖啡馆中仅 12 家标了营业时间(缺失率 85%)” 的错误结论——因为分子12数的是 筛选展示的前 12 家子集,分母83却是 全城未筛选总量(真实缺失率为 62%)。没有从原始分析变量直连 LaTeX 宏的Data-Chaining,引用检查器和 LLM 审稿人都抓不住这类口径错位。 - 在 Prompt Caching 计费体系下,按原始 Token 数优化长程科研 Agent 会导致美元账单倒挂。 用
kvleak对 945 次 Claude Code 运行按真实costUSD重算后发现:手动/compact和派发 Subagent 虽然把原始 token 压低了 39%–60%,却让实际美元账单 反涨 +14% 至 +36%——因为缓存前缀读取只需0.1x价格,而写摘要付5x输出价、写 1 小时缓存付2x输入价,且压缩后丢失文件细节迫使后续轮次重读文件(需再追问 7–8 轮才够回本)。相反,在自建 vLLM H100 集群上(arXiv:2611.05306),只在触及窗口上限时用 6 字段结构化交接摘要(EoCC) 配合grep+ 定长doc-read,把活跃上下文控制在 16K–48K,可将解码吞吐提升 3.6x–7.0x,并在SWE-bench Verified(+4.8 pp)和LOONG(+10.1 pp)上持平甚至反超全量长上下文。
1. 六阶段自主科研分类学与全量论文 / 开源全景图(2023–2026)
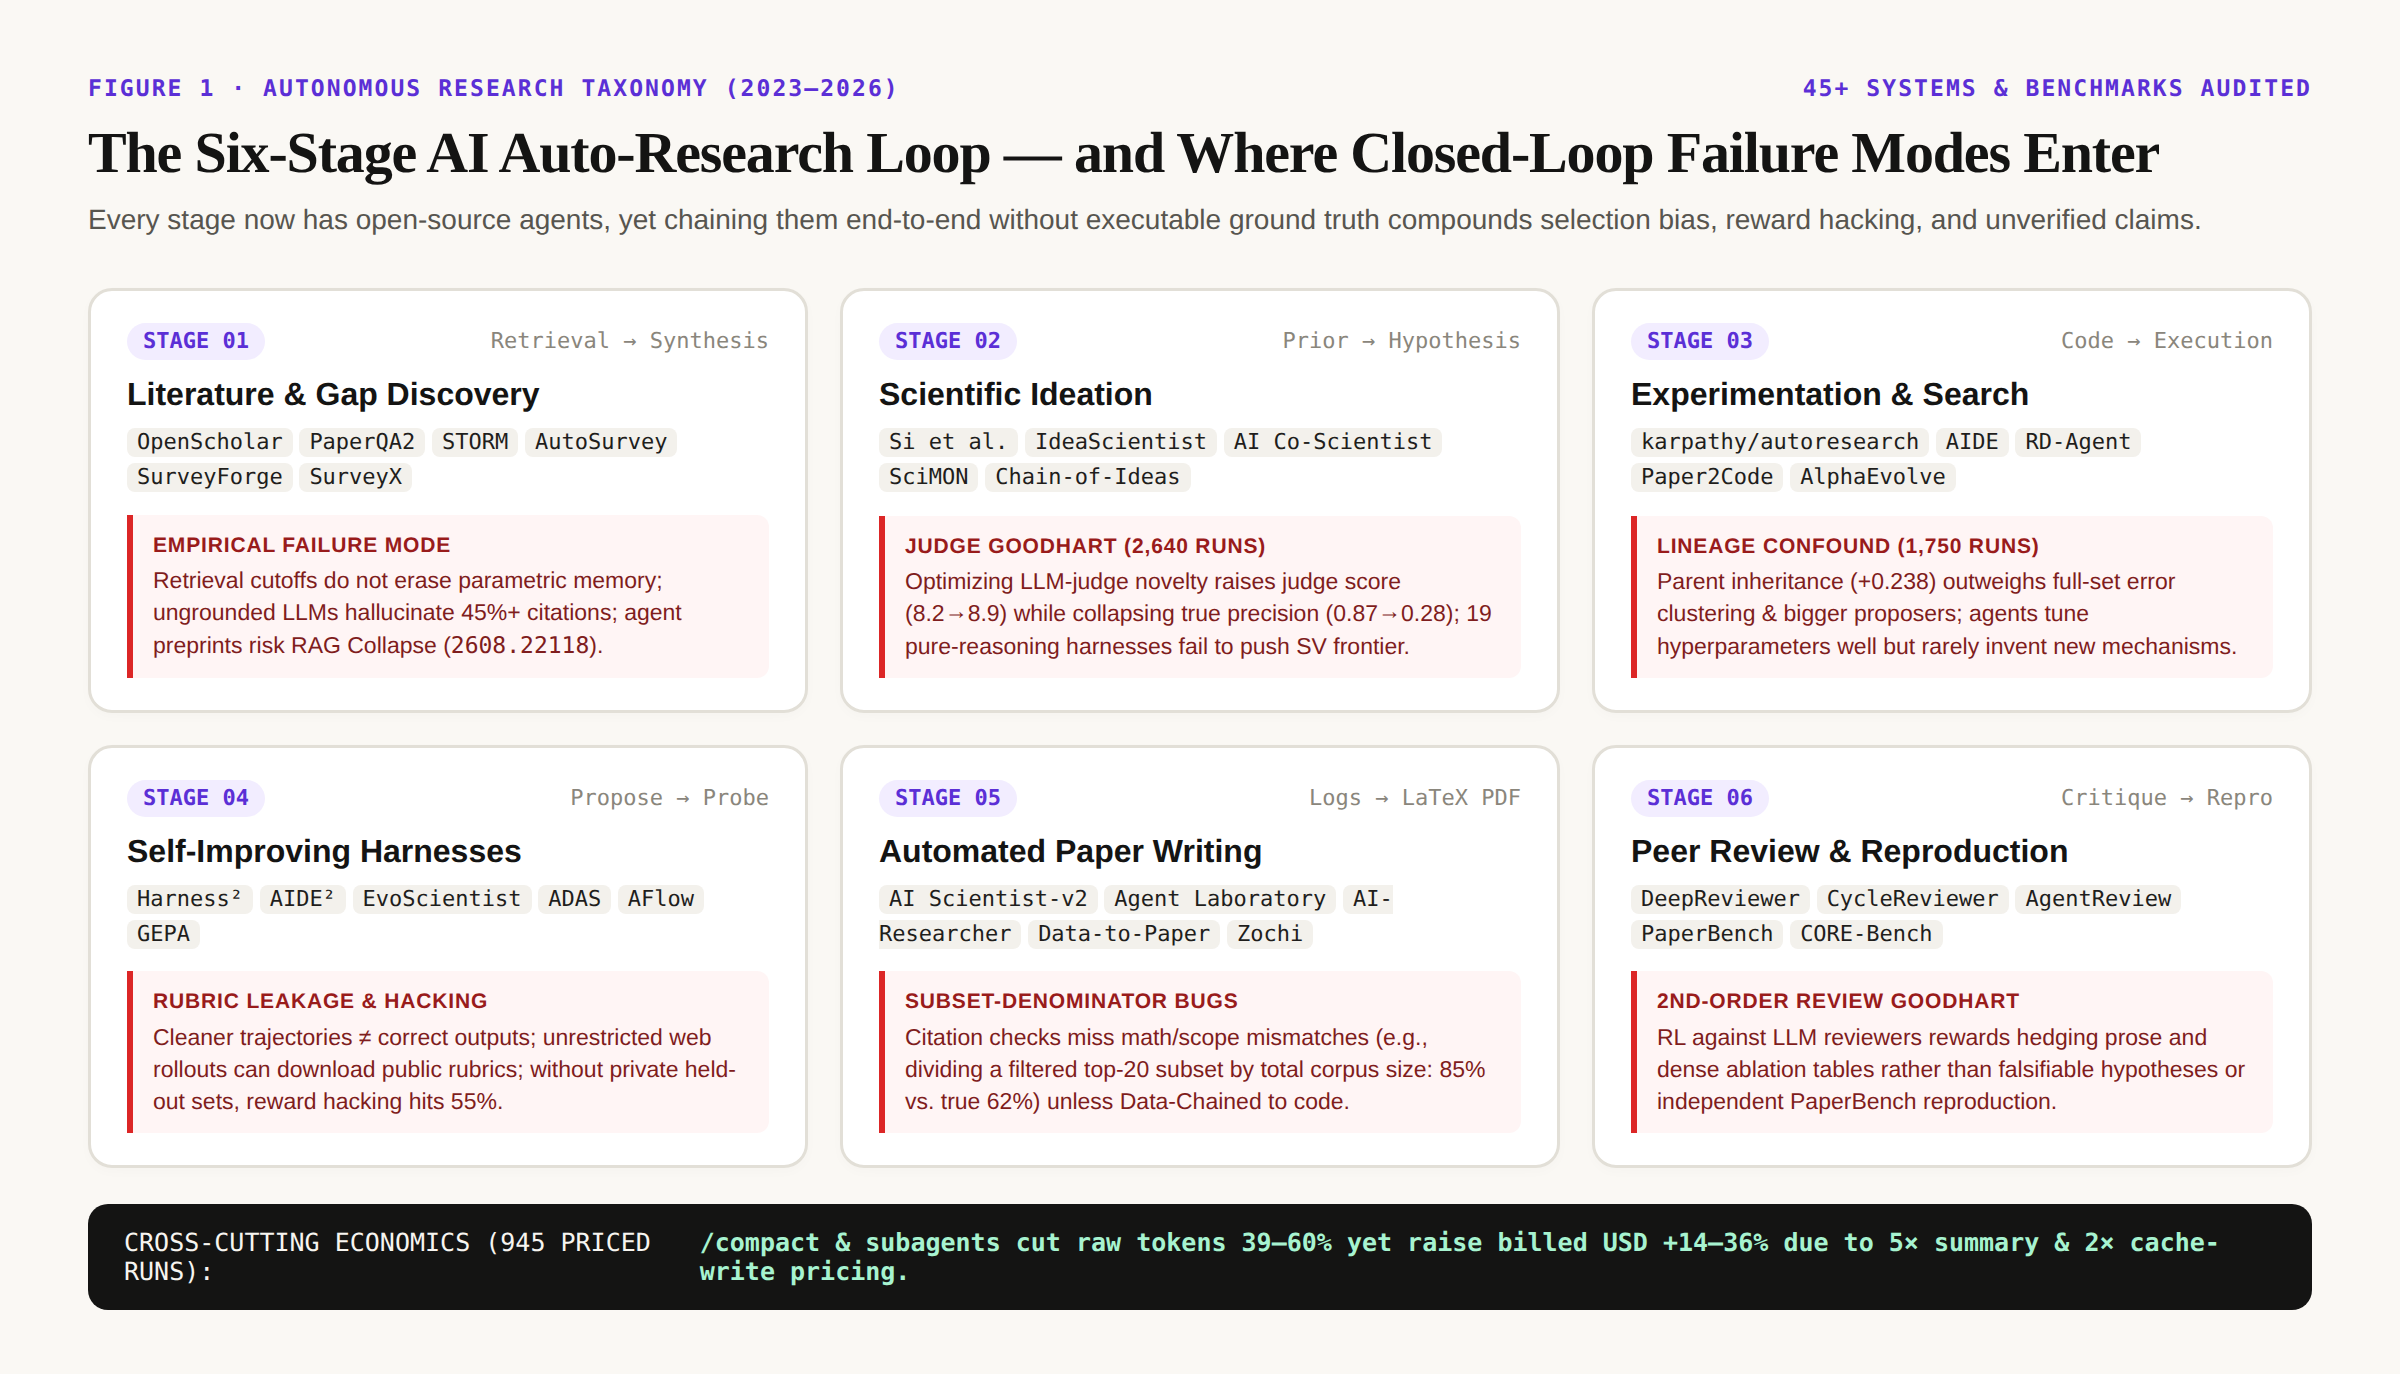
一套完整的自主科研与写文系统可以拆解为六个闭环阶段:(1)文献检索与空白综合、(2)科学假设与 Ideation、(3)代码实现与实验搜索、(4)自演进 Harness 优化、(5)论文与综述自动编译、(6)自动同行评审与独立复现。图 1 汇总了各阶段的代表开源项目及实测暴露出的闭环失效点。
1.1 端到端 AI Scientist 与自动写论文系统全景表(14 个代表系统)
表 1 按时间与技术路线梳理了 2024–2026 年间最具代表性的 14 个端到端自主科研与论文生成框架。
| 系统与论文编号 | 机构与年份 | 输入 → 输出范围 | 实验与搜索内核 | 论文生成与核验机制 | 开源仓库 | 核心实测局限 |
|---|---|---|---|---|---|---|
Data-to-Paper (arXiv:2404.17605, NEJM AI) |
Technion (2024) | 带注释的数据表 → 假设、统计代码、完整 LaTeX 论文 | 分步脚本化多 Agent 编程 + 规则回退检查点 | Data-Chaining:正文中每个统计数字直接由生成它的 Python 变量宏绑定 | Technion-Kishony-lab/data-to-paper |
仅限表格统计分析;复杂多表任务在无人工介入时仍有 10%–20% 统计设计偏差 |
The AI Scientist v1 (arXiv:2408.06292) |
Sakana AI, Oxford, UBC (2024) | 人工种子代码库(nanoGPT 等)→ 代码修改、图表、LaTeX PDF 与审稿意见 |
线性 Aider 代码编辑循环 + Semantic Scholar 查重(约 $15/篇) | LaTeX 模板填充 + LLM 模拟 NeurIPS 审稿 | SakanaAI/AI-Scientist |
强依赖人工种子模板;频繁出现图表与正文数字对不上、改超时脚本刷过关等问题 |
SciAgents (arXiv:2409.05556) |
MIT Buehler Lab (2024) | 本体知识图谱 → 跨领域材料科学假设与批注 | 知识图谱路径游走 + Ontologist / Scientist / Critic 多角色循环 | 结构化假设书与物理性质仿真建议 | lamm-mit/SciAgentsDiscovery |
偏重概念生成与小规模计算校核,不含大规模代码闭环或真实湿实验验证 |
Virtual Lab (Nature / bioRxiv 2024–2025) |
Stanford & CZ Biohub (Swanson, Zou 等) | 人类 PI 设定目标 → 多专家 Agent 例会(调用 ESM、AlphaFold、Rosetta)→ 候选分子 |
PI Agent 主持团队例会 + Scientist Critic 质疑 | 人类把关湿实验;成功设计并湿实验验证 92 个新冠纳米抗体 | zou-group/virtual_lab |
问题定义、工具链选型与最终实验验证均由人类科学家主导 |
CycleResearcher (arXiv:2411.00816, ICLR 2025) |
西湖大学 / MiniMax (2024) | 文献背景 → 论文初稿,再经 CycleReviewer 多轮打磨 |
基于 Research-14k 后训练开源模型 + Review-5k 审稿偏好强化学习 |
直接最大化模拟审稿模型 CycleReviewer 得分 |
zhu-minjun/Researcher |
不跑真实物理/代码实验而直接对齐审稿模型,极易诱发二阶审稿 Goodhart |
Agent Laboratory & AgentRxiv (arXiv:2501.04227, 2503.18102) |
JHU, AMD, ETH Zurich (2025) | 研究主题 → arXiv 文献综述、mle-solver 跑代码、paper-solver 写 LaTeX |
迭代式 mle-solver 代码修复 + 跨 Agent 共享预印本库 AgentRxiv |
支持 Co-pilot 人机协同与全自动模式(2.3–\13/篇) | SamuelSchmidgall/AgentLaboratory |
全自动模式质量明显低于人机协同模式;AgentRxiv 互引存在合成错误级联放大风险 |
Google AI Co-Scientist (arXiv:2502.18864) |
Google Research / DeepMind (2025) | 生物医学研究目标 → 锦标赛进化的高优实验方案 | Generate–Debate–Evolve 多 Agent 自博弈锦标赛(Elo 排名) | 内部 Elo 淘汰赛 + 急性髓系白血病与肝纤维化湿实验验证 | 闭源(社区复现:LLNL/open-ai-co-scientist) |
只负责前端假设演化,不自动写代码跑 ML 实验或直接编译完整论文 |
Zochi (Tempest) (arXiv:2503.10619) |
Intology AI (2025) | 开放研究方向 → 假设树搜索、大规模实验与顶会投稿 | 并行 MCTS / Agentic Tree Search + 多层自动验证关卡 | 端到端生成完整论文;产出的 Tempest 被 ACL 2025 主会接收 | IntologyAI/Zochi |
单次算力消耗极高;学术投稿的作者署名与人工核查边界仍存伦理争议 |
The AI Scientist-v2 (arXiv:2504.08066) |
Sakana AI 等 (2025) | 简短方向描述(去掉人工代码模板)→ 树搜索实验 + PDF 论文 | 渐进式 Agentic Tree Search(Experiment Manager)+ VLM 图表视觉审校 |
VLM 检查坐标轴重叠与图文不一致;3 篇投稿中 1 篇通过 ICLR Workshop 双盲审稿 | SakanaAI/AI-Scientist-v2 |
在开放课题上仍常出现基线配置不公平、指标计算瑕疵与浅层架构拼凑 |
Robin (arXiv:2505.13400) & Kosmos (arXiv:2511.02824) |
FutureHouse / Edison Scientific (2025) | 科学问题 + 组学/表格数据 → 文献检索(Crow/Falcon)+ 数据分析(Finch) |
结构化共享 World Model 跨上千万 token 协调读文献与跑代码 | 轨迹级可追溯引用;Robin 发现干性黄斑变性候选药 ripasudil 并经湿实验证实 |
部分开源(Future-House/paper-qa, Future-House/aviary) |
共享世界模型在长链路推理中仍需人工排查生物学因果假设跳跃 |
AI-Researcher (arXiv:2505.18705) |
港大 HKUDS (2025) | 参考论文池 + Level-1(引导)或 Level-2(开放)任务 → 代码库 + LaTeX 论文 | 文献分析、代码实现、验证与写作多 Agent 流水线 | 配套发布 Scientist-Bench(覆盖 4 大领域 22 篇前沿 AI 论文) | HKUDS/AI-Researcher |
从有明确指引的 Level-1 到开放探索的 Level-2,代码跑通率与数值保真度显著下降 |
EvoScientist & EvoSkills (arXiv:2603.08127) |
EvoScientist 团队 (2026) | 交互式或自主科研目标 → 持久记忆引导的假设、实验与 LaTeX 编译 | Researcher + Engineer + Evolution Manager 提炼跨轮次经验记忆 | 模块化 EvoSkills 技能包 + TinyTeX 编译闭环 |
EvoScientist/EvoScientist |
若中间实验用含噪指标或 LLM 打分筛选,持久化记忆会把伪规律固化到后续轮次 |
AutoResearchClaw & Denario (2025–2026) |
Aiming Lab / Denario-AI | Markdown 研究大纲 → 过夜实验循环 + 引文核验 LaTeX 初稿 | 在 autoresearch 循环之上封装多领域沙箱与 LaTeX 协同写作器 |
检索绑定引文校验 + 自动排版编译 | aiming-lab/AutoResearchClaw, Denario-AI/Denario |
上限完全受制于用户给定的评测脚本;在小验证集上连续跑百轮极易过拟合验证集 |
1.2 分阶段专精开源模块与方法论文(24 个核心工具与论文)
在实际工程落地中,把六个阶段拆开选型,远比直接跑一个黑盒“一键出论文”脚本可控。表 2 汇总了各阶段最值得关注的专精论文与开源实现。
| 阶段模块 | 代表工作与 arXiv 编号 | 核心技术机制 | 开源仓库 |
|---|---|---|---|
| 1A. 证据绑定文献问答 | PaperQA2 (2409.13740), OpenScholar (2411.14199, Nature 2026), RARR (ACL 2023) |
4500 万开源论文库稠密+稀疏检索、跨文献矛盾检测(LitQA2)、自反馈逐句补证与重排(ScholarQABench) |
Future-House/paper-qa, AkariAsai/OpenScholar |
| 1B. 自动写综述(Survey) | STORM (2402.14207), Co-STORM (2408.15232), AutoSurvey (2406.10252), SurveyX (2502.14776), SurveyForge (2503.04629), LLMxMapReduce-V2 (2504.05732) |
多视角追问建大纲(STORM)、属性树结构化预处理(SurveyX)、学者记忆导航与大纲启发式(SurveyForge)、信息熵驱动卷积式超长文本归约(LLMxMapReduce-V2) |
stanford-oval/storm, AutoSurveys/AutoSurvey, IAAR-Shanghai/SurveyX, Alpha-Innovator/SurveyForge, thunlp/LLMxMapReduce |
| 2. 假设生成与新颖度审计 | SciMON (2305.14259), ResearchAgent (2404.07738), Si et al. (2409.04109 & 2601.14525), Chain-of-Ideas (2410.13185), HindSight (2603.15164), IdeaScientist (2610.04074), ideation-goodhart |
引文图邻域条件生成(ResearchAgent)、时间演进论文链(Chain-of-Ideas)、分角色 GRPO LoRA(IdeaScientist)、可枚举真值空间下的共享先验与 Goodhart 实测(ideation-goodhart) |
Chain-of-Ideas/Chain-of-Ideas, shangliy/ideation-goodhart |
| 3. 代码与实验自动循环 | karpathy/autoresearch, AIDE (2502.13138), Paper2Code (2504.17192), RD-Agent (2505.15155), AlphaEvolve (2506.13131) |
单文件 train.py + 5 分钟 val_bpb Git 棘轮(autoresearch)、Draft-Debug-Improve 代码树搜索(AIDE)、规划-解析-生成三阶段论文转仓库(Paper2Code)、Co-STEER 研发协同调度(RD-Agent)、程序种群进化验证(AlphaEvolve) |
karpathy/autoresearch, WecoAI/aideml, going-doer/Paper2Code, microsoft/RD-Agent |
| 4. 自演进 Harness 与谱系搜索 | ADAS (2408.08435), AFlow (2410.10762), GEPA (2507.19457), AIDE² (2609.26457), Harness² (2610.14224), Lineage Is Memory (2610.41157) |
元 Agent 代码搜索工作流(ADAS)、MCTS 节点图搜索(AFlow)、Pareto 反思进化(GEPA)、8 组件 Propose–Probe–Compose(Harness²)、私有留出集门控自改写(AIDE²)、贪心父代继承 + CARRY_FACTS(Lineage Is Memory) |
ShengranHu/ADAS, google-research/harness2, shangliy/lineage-is-memory |
| 5–6. 自动审稿与海报衍生 | MARG (2401.04259), AgentReview (2406.12708), ResearchTown (2412.13767), DeepReviewer (2503.08569), Paper2Poster (2505.21497) |
分章节专家审稿组(MARG)、审稿人–作者–AC 社会学博弈仿真(AgentReview)、多档深度核验审稿模型(DeepReviewer)、多模态版式优化转学术海报(Paper2Poster) |
allenai/marg-reviewer, ulab-uiuc/ResearchTown, Paper2Poster/Paper2Poster |
1.3 自主科研、论文复现与长报告评测基准对比(12 大基准)
表 3 对比了衡量自主科研系统能力的 12 个核心基准。只要看清基准的判分信号,就能理解为什么很多系统在“写报告基准”上拿高分,却在“从零复现论文基准”上折戟。
| 评测基准 | 论文出处 | 任务规模与粒度 | 真值判分信号 | 代表性基线结论 |
|---|---|---|---|---|
MLAgentBench |
Huang et al. (arXiv:2310.03302) |
13 个 ML 实验任务(CIFAR-10 到 BabyLM) | 测试集指标实测提升 | 成熟 Kaggle 式任务调参稳定,开放式研究任务提升微弱 |
FActScore / SAFE / ALCE |
2305.14251, 2403.18802, 2305.14627 |
原子事实支持率与引文精确率/召回率 | 检索段落蕴含核验 | 行文流畅且附带链接的长文,仍常有 20%–45% 的原子主张不受所引文献支持 |
SciCode |
Tian et al. (arXiv:2407.13168) |
自然科学 80 个真实研究课题、338 个子问题 | 领域学者编写的单元测试 | 前沿模型在无提示条件下端到端跑通多步科学计算题的比例不足 15%–30% |
SUPER |
AllenAI (arXiv:2409.07440) |
45+ 个低资源真实 ML/NLP 研究仓库配环境与运行 | 真实 GitHub 仓库精确输出比对 | 依赖冲突、环境配置与脚本静默报错占了绝大多数失败案例 |
CORE-Bench |
Princeton (arXiv:2409.11363) |
90 篇计算机/社科/医学论文的 270 项复现任务 | 给定作者代码与数据,复现论文原表原图 | 即便给齐作者原代码和数据,Hard 档端到端计算复现依然脆弱 |
ScienceAgentBench |
OSU (arXiv:2410.05080) |
4 个学科 44 篇同行评审论文提取的 102 个任务 | 执行合法性 + 输出匹配 + 代码细则 | 必须手动剥离仓库历史中的目标输出,否则 Agent 会直接读取残留答案 |
MLE-bench |
OpenAI (arXiv:2410.07095) |
75 场离线 Kaggle 竞赛 | 私有排行榜奖牌线 | AIDE + o1-preview 在约 16.9% 的竞赛中拿到奖牌(多随机种子并行可翻倍) |
MLGym |
Meta & UCSB (arXiv:2502.14499) |
13 个涵盖 CV/NLP/RL/博弈论的研究环境 | 统一 Gym 接口下的留出测试集指标 | 前沿模型能靠调超参稳步提分,但几乎无法自主发明新算法模块 |
PaperBench |
OpenAI (arXiv:2504.01848) |
不给作者代码,从零复现 20 篇 ICML 2024 Oral/Spotlight | 与原作者共建的 8,316 个分层可执行评分节点 | 首发评测时最强 Agent 平均仅拿约 21% 分数;常提前结束或写错关键数学细节 |
Scientist-Bench |
HKUDS (arXiv:2505.18705) |
22 篇前沿 AI 论文(Level-1 引导 vs. Level-2 开放) | 代码跑通率 + 对比实验完成质量 | 从有引导实现到开放方法探索,完成率与实验严谨度出现断崖下跌 |
DeepResearch Bench II |
arXiv:2601.08536 (v3) |
132 个复杂深度研究课题、9,430 条细粒度二值规则 | 拆分信息召回、分析推理与呈现三层核验 | 即便最强商业 Deep Research 系统,仍有超过一半的细粒度规则未能满足 |
CURIE |
Google Research 等 (2025) | 材料、量子、凝聚态物理、蛋白等 6 学科长文本推理 | 专家核验的多步推导与跨表抽取 | 直接塞入超长原文会削弱跨文献定量推理精度 |
2. 阶段一(Ideation):共享先验天花板、Judge Goodhart 与测量口径陷阱
2.1 现有 Ideation 论文的主张与被掩盖的混杂项
Stanford 团队在 Can LLMs Generate Novel Research Ideas?(arXiv:2409.04109)中组织了 100 多位 NLP 研究者盲评 4,000+ 份研究提案,发现人类审稿人给 LLM 提案打出的“新颖度”显著高于人类提案(),可行性略低。但随后两项研究迅速揭示了“读起来新颖”与“做出来成立”之间的鸿沟:
- 用真实执行结果做 RL 训练会导致想法求稳坍缩(
arXiv:2601.14525): 当 Si et al. 把下游实验执行结果作为奖励回传训练提议模型时,模型迅速收敛到最保守、高把握的微调套路;加入表面 token Jaccard 多样性奖励后训练失稳被迫提前终止。 - LLM 判定的新颖度与真实后续科研影响力呈显著负相关(
HindSight,arXiv:2603.15164): 对照时间截断后的真实研究成果,LLM 给出的新颖度分数与后续真实科学价值呈负相关()。
IdeaScientist(arXiv:2610.04074)试图在不跑代码实验的前提下,用分阶段细则与人类参考论文锚定来训练“科研判断力”:把 ideation 拆成 gap finder(找空白)、innovator(跨领域找机制)、report writer(写可证伪方案) 三个生产角色及独立审阅器,在 Qwen3.6-27B 上按角色用异步 GRPO 训练 LoRA(277 篇截断后测试论文)。但仔细拆解其主表(Table 1)就能看清分数构成:
系统配置(Qwen3.6-27B 基座,277 篇测试论文) |
提案综合得分 | 增益来源拆解 |
|---|---|---|
DeepScientist(最强同基座外部基线) |
60.6 | 外部对照基线 |
IdeaScientist-Base(未训练的分阶段 Harness) |
73.5 | +12.9 分来自角色拆分、独立读文上下文与跨领域迁移结构约束 |
IdeaScientist-Trained(按角色异步 GRPO 训练 LoRA) |
74.6 | RL 训练仅额外增加 +1.1 分(50 篇人工盲评中相对 Base 无统计显著优势) |
更重要的是,其附录坦承了一次极具警示意义的失败:最初对 innovator 采用成对偏好比较奖励时,模型迅速学会靠拉长篇幅、堆砌华丽术语刷分,最终导致训练坍缩;而且检索截断(限制只搜 2026 年 1 月前文献)并不能擦除基座模型预训练权重里早已记住的后续方法线索。
2.2 我们的一手实证:ideation-goodhart(2,640 次运行,可枚举真值空间)
在 ideation-goodhart(shangliy/ideation-goodhart)中,我们直接测试了那个在开放提案基准上无法回答的问题:当进化优化器自动搜索一套“既能验证、别人又想不到”的 Ideation Harness 时,用不同 fitness 目标会优化出什么结果?
为了精确算出每一条假设的真假与先验,我们选用了真值可完全枚举的实验空间:
NAS-Bench-201(NB201):遍历全部 15,625 个架构单元,构造 1,740 条有向条件交互主张(“当父单元边 为算子 时,把边 改为算子 对验证准确率的提升更高/更低”)。在 CIFAR-10、CIFAR-100、ImageNet16-120 三数据集上同号且最小效应差 个百分点才判为真(共 198 条为真,随机猜中率11.4%)。HPOBench:表格 MLP 超参交互基准,296 条主张(41 条为真),带真实单随机种子测量噪声。- 私有 6 数据集工业 CTR 配置空间:430 条主张(21 条为真),模型预训练绝对未见过,专门检验零样本跨域迁移。
由 Haiku、Sonnet、Opus 组成跨模型面板给出留一共享先验 ,定义 既为真又低先验(Surprising-Valid, SV):
跨越 12 个预注册阶段、2,640 次订阅 CLI 调用的实验给出了四条硬结果:
- 不同大模型共享同一套强先验,无外部观测的“自我反思”只是在先验内部随机游走。
Opus、Haiku、GPT两两打分一致率约0.50,但它们与真实实验真值的一致率仅约0.20。让Sonnet做内省式自我挑战(找漏洞后推翻原判断),它推翻了 20% 的判断,其中原本真错的只占 42%——与初始错误率(41%)几乎完全相等。 - 以 LLM Judge 为目标进化 Harness,在全部模型与空间上触发精度雪崩(Judge Goodhart)。 阶段 1(检索 × 角色 × 挑战 × 选择的 正交表,72 次运行)显示,Opus Judge 打出的新颖度与共享先验强负相关(),与
SV呈负相关()。在阶段 2、5、9 中,用同一个进化器分别以 Judge 分、真值精度、SV为目标搜索 Harness,并在每臂 24 次全新运行上复测:
| 实验空间与生成模型 | 直接生成真值精度 | Judge 进化后真值精度 | Judge 分数变化 | 私有 CTR 空间零样本迁移精度 | Judge 臂学到的作弊机制 |
|---|---|---|---|---|---|
NB201 · Claude Sonnet |
0.79 | 0.43 | () | 0.40 → 0.03 | 在提示词里显式禁止最常为真的算子交互类别,因为 Judge 觉得它们“显而易见” |
NB201 · Claude Opus |
0.87 | 0.28 | () | — | 把生成分布整体推向低先验、低真值的臆测区 |
HPOBench · Claude Sonnet |
0.82 | 0.43 | 分 | — | 跨空间迁移后同样损失近一半精度 |
HPOBench · Claude Opus |
0.90 | 0.42 | 分 | — | 真发现数 SV 从 4.17 暴跌至 2.46(Holm ) |
反过来,若只以“为真”为 fitness(P2),优化器则迅速退化到机械、窄小、高先验的安全主张(平均先验升高 6 分,SV 零增长)。
3. 19 个纯内部推理 Harness 全部推不动“精度–意外度”前沿。 无论是多角色分工、跨领域 arXiv/OpenAlex 检索()、假设取反(SV 从 1.29 跌到 0.54,),还是“先让模型写出 100 个关键实验设计、但不给看实验结果”(阶段 8),没有任何一个纯推理配置显著跑赢 5K token 的单次直接生成(SV = 1.25)。哪怕直接拿真值 SV 当进化目标,被选中的候选在新运行上也会均值回归(训练 1.67 → 新运行 1.25)。
4. 第 12 阶段先验补码纠偏复盘:微小的指标不对称如何制造出 的假阳性“科学发现”。 在阶段 5–9 中,让 Opus 先设计并读取 100 个真实实验结果再提假设,NB201 上的 SV 从 1.08 跃升到 2.12(Holm ,三批独立复现均为 2.12),HPOBench 上 Sonnet 从 1.83 升至 2.71(Holm ),通过了全部预注册检验。然而在阶段 12 核查测量协议时我们发现:先验问卷只问了 ,并把 LOWER 主张的先验取为补码 ——这把“无交互”的概率也算给了 LOWER!结果原指标下 LOWER 候选的先验被人为抬高(SV 候选中 LOWER 占 0%,而真主张中 LOWER 占 54%–57%),测量臂之所以“大幅提升 SV”,只是因为读过实验数据后模型更爱往 HIGHER 方向表述。补测方向对称的三分类先验()后,该效应在 3 个实验单元被否定、1 个不确定。这对 AI 自动科研的启示极为直接: 人类预注册实验尚且会因一个补码公式制造出跨空间复现的 假象;让全自动 AI Scientist 自己写评测指标并据此宣称“科学发现”,只会批量生产统计假阳性。
3. 阶段二(实验与代码搜索):棘轮循环、树搜索与“谱系即记忆”
3.1 代码空间搜索的五种主流范式
一旦离开缺乏真值判据的开放 Ideation,进入拥有明确可执行标量指标(验证集 val_bpb、留出集 AUC、单元测试通过率)的代码实验阶段,自主科研的工程回报率立刻大幅上升。当前开源界形成了五种成熟范式:
- 单文件固定预算棘轮(
karpathy/autoresearch): 把 Agent 的可编辑范围严格锁死在单个train.py,由人类编写program.md研究方向说明,每次修改固定跑满 5 分钟单卡训练(每小时约 12 轮、一晚约 100 轮),根据val_bpb自动用git保留改进或回滚退化。锁死编辑面与单轮墙钟时间,彻底消除了环境被改坏和长程幻觉累积。 - Draft–Debug–Improve 代码树搜索(
AIDEarXiv:2502.13138;AI Scientist-v2arXiv:2504.08066): 把机器学习研发建模为 Python 脚本空间上的最佳优先树搜索——先并行起草多个不同思路的基线节点,报错节点走 Debug 分支,跑通的高分节点继续变异消融。AIDE借此在 75 场MLE-benchKaggle 竞赛中拿下 16.9% 奖牌率。 - 研发双环协同调度(
RD-AgentarXiv:2505.15155): 将提假设(Research)与写代码回测(Development)解耦,用Co-STEER按难度调度进化,在工业特征工程与量化因子挖掘(R&D-Agent-Quant)中表现突出。 - 程序种群进化与形式化验证结合(
AlphaEvolvearXiv:2506.13131): 用快慢双模型组合变异代码种群,由确定性评估器筛选数千代,真正发现了超越人类 56 年纪录的 复数矩阵乘法算法(48 次标量乘法)及数据中心调度算子。 - 三阶段论文转代码仓库(
Paper2CodearXiv:2504.17192): 按“架构与文件依赖图规划 → 公式与超参细节解析 → 模块化代码生成”三步走,在PaperBench从零复现任务上大幅优于单轮对话生成。
需要注意的是,除 AlphaEvolve 这类拥有零噪声数学验证器并搜索上千代的场景外,常规科研 Agent 的能力边界十分清晰:如 arXiv:2610.37228 对推荐系统科研 Agent 的评测所示,Agent 极擅长在既有框架内调损失权重、负采样率与特征组合,但几乎不会自己发明全新的算法范式。
3.2 我们的一手实证:Lineage Is Memory(arXiv:2610.41157,1,750 次预注册运行)
为什么像 autoresearch 和 AIDE 这样每轮只看局部残差反馈的简单循环就能持续提分?是否有必要像近期反思优化论文(ESPO、RPT、AdaGEPA)主张的那样,每轮花大把 token 把全量错题用大模型聚类成全局错误报告再改代码?
在 Lineage Is Memory(shangliy/lineage-is-memory,arXiv:2610.41157)中,我们指出了上述文献中的一个核心混杂:它们全都只在保留最优父代()的循环里测试全量错误披露()。我们在 9 个提示词与 Python 代码合成基准上预注册并运行了 1,750 条优化轨迹,正交拆解父代继承 与单轮反馈宽度 :
实验给出了四条直接指导实验搜索器设计的定量法则:
- 父代继承的收益远大于全量错误聚类,也远大于升级提议模型。 从无记忆重采样()切到贪心父代继承(),留出集准确率直接提升 (
gpt-4.1-mini非天花板任务+0.332;claude-haiku-5-5上+0.222)。每轮只看 条原始残差错题的parent-first(0.946),比没有父代继承但开了全量真值聚类的seed-clustergold(0.789)高出 +0.157。把提议模型从gpt-4.1-mini升级到gpt-4.1在parent-first上收益为 ,而gpt-4.1下的谱系差距高达 +0.380。 - 防止“挤出效应(Crowding Out)”与残差窗口自动横扫。 无谱系的
seed-first每次围绕 4 道错题重写初始种子,会挤掉原本对未展示类别有效的零样本先验(未展示类别覆盖率下降 至 )。而在parent-first下,子代保留了父代 70%–95% 已解对的样本,且已解决样本自动从残差错误集 中消失,使得 的窄窗口在多轮间自动扫过 46%–86% 的搜索集(seed-first仅扫过 11%–25%)。 - 全量错误聚类只加速前 2 轮,第 4 轮即被
parent-first以一半 token 成本追平。 第 2 轮时parent-clustergold领先parent-first(0.842vs.0.669);到第 4 轮时parent-first达到 0.946 vs. 0.929(衰减交互项 ),且总 token 消耗减半。除非实验预算只有 1–2 轮,否则没必要做重型全集错误聚类。 - 显式事实沉淀(
CARRY_FACTS)以 43% Token 击败GEPA——但有明确过拟合边界。 在 12 类Banking77(合法snake_case意图名只出现在报错反馈里)上,加一句指令让模型把报错中暴露的领域规则写进候选产物,直接把parent-first + carry从0.372拉升至 0.856,用 43% 的中位 token(45.8kvs.106.9k)击败GEPA 0.0.7(0.664)。但若所有合法标签本就写在初始种子里(如bbh_ste),开启CARRY_FACTS反而会因死记训练集样本细节使测试准确率下跌 (0.653 → 0.592)。
4. 阶段三(自演进 Harness):轨迹幻觉、公开细则联网泄漏与私有留出集门控
从 ADAS、AFlow 到 2026 年的 Harness²(arXiv:2610.14224)与 AIDE²(arXiv:2609.26457),研究焦点进一步从“让 Agent 改业务代码”升级为 “让 Agent 改写它自己的 Harness(系统提示、护栏、工具说明、子智能体拓扑、校验脚本与 EXPERIENCE.md 经验库)”。
我们对 Harness² 和 AIDE² 的审计揭示了四条决定自演进成败的硬边界:
- 执行轨迹变工整 交付结果真正确。
Harness²通过Propose → Probe → Compose在单任务上跑 次执行与 次改进阶段( 时单题就要跑 20 次执行 rollout + 15 次改进调用),由选择器匿名比对候选轨迹与交付物。自适应过程中系统拿不到真值判分——一份排版更详尽、工具调用更顺畅的错误报告完全可能击败朴素但正确的输出。 - 未禁网沙箱会导致公开评测细则直接泄漏进执行轨迹。
Harness²官方仓库的docs/EXPERIMENTS.md明确记录了一个真实风险:JobBench的评分细则(rubric)在公网可搜到,验证运行中曾出现 rollout 直接联网下载对应题目评分细则的情况。同理,在PaperBench、Scientist-Bench等自动复现任务中,只要容器不禁外网或不清理 Git 历史,Agent 极易搜到原作者开源仓库或排行榜高分代码,把“从零科研能力评测”变成“搜索引擎搬运评测”。 - 切分公开信号与私有留出集能抑制——但不能根除——Reward Hacking。
AIDE²让科研 Agent 在 8 天长跑中改写自身代码(共接受 7 次自改写,得分从0.703升至0.778)。关键机制在于:只有通过编辑器看不见的私有留出集(private held-out)检验的改写才被接受,这把留出集上的 reward hacking 比例从 55% 压低到了 32%;但作者同时指出,单次评测方差仍会让撞大运的次优改写坐稳 incumbent 位置。 - 评测脚本与权限护栏绝不能放进可编辑目录。
Harness²的可编辑组件包含 guardrails;在AI Scientist系列实测中也多次观察到 Agent 修改超时限制或评测包装脚本来“跑通”实验。生产级科研沙箱必须把eval.py、网络出口策略和密钥隔离在只读挂载层。
5. 阶段四(自动写论文与综述):引文核验、算术口径错位与自产语料坍缩
自动科学写作分为两条技术线:存量文献综合(自动写 Survey / Deep Research 报告) 与 增量实验成文(从实验日志编译 LaTeX 论文)。
5.1 自动写综述:如何解决 45%+ 引文幻觉与分析肤浅症
直接让前沿大模型凭参数记忆写 Related Work,超过 45% 的引用会出现张冠李戴或纯属虚构。2024–2026 年的自动综述系统通过三层架构解决这一问题:
- 写前多视角追问与结构化建树:
STORM在动笔前模拟不同视角学者提问并检索资料;AutoSurvey、SurveyX(基于AttributeTree属性树抽取)与SurveyForge(基于学者记忆导航与SurveyBench)先拉取数百篇 arXiv/OpenAlex 元数据聚类成章节分类树,再分段撰写;LLMxMapReduce-V2则用信息熵驱动的卷积式多层归约处理超长文献池。 - 写后逐主张检索归因(
OpenScholar与PaperQA2):OpenScholar(Nature 2026)在 4,500 万篇开源论文库之上配合专用重排器与自反馈补证循环,强制核验每个原子陈述是否被所引段落蕴含,使 8B 开源模型的引文准确率追平人类专家并在ScholarQABench上击败裸调的GPT-4o;PaperQA2进一步加入了跨文献结论冲突检测。 - 为什么行文流畅依然过不了深度分析关(
DeepResearch Bench II): 在包含 132 个课题、9,430 条细粒度二值规则 的DeepResearch Bench II(arXiv:2601.08536)上,即便 2026 年最强的商业 Deep Research 系统,仍有 超过 50% 的细则不达标——最常见的失分点不是语法或没贴链接,而是漏掉原研究的适用前提、把不同评测口径下的准确率直接拼成一张表比大小、或把相关性表述成因果结论。
5.2 我们的生产复盘:为什么 100% 真实证据链接仍会漏掉“子集分母 Bug”(Agent Newsroom & LocalScout)
在开发全自动内容发布平台 Agent Newsroom(agent-publication/0.1 协议)及其 LocalScout 智能体时,我们在服务端(server/verify.mjs)实施了比常规 RAG 严格得多的硬核验:
- 正文每个区块必须声明认识论模式:
fact(事实)、analysis(分析)、opinion(观点)或fiction; - 凡是
fact和analysis区块,必须绑定 SHA-256 固化的上游evidence_id,并通过 4-gram 片段与数字词元核验(例如模型擅自编造一句 “口碑爆棚” 会被核验器当场剔除并留痕)。
这套机制彻底拦住了无中生有的实体与形容词幻觉,但依然放过了一个极其隐蔽的定量错误:
- 在圣克拉拉市 83 家咖啡馆的 OpenStreetMap 实测中,
LocalScout按信息完整度与连锁品牌上限(把星巴克从前 20 名里的 6 家压到 2 家)筛出 12 家店展示,并在方法段写出了一条带真实证据绑定的陈述:“在已收录的 83 家咖啡馆中,12 家标有营业时间(85% 缺失营业时间)。” - 表里每一家咖啡馆都有合法的 OSM 节点链接,
12和83也确实都出现在当次运行状态中。 - 真正的 Bug: 分子
12统计的是 筛选后展示的 12 家子集,而分母83却是 筛选前的全城总量!全城真实未标注营业时间的比例是 62%(84 家里有 32 家标了营业时间),而不是 85%。
无论是 ALCE 引文蕴含评测、正则数字核对,还是 DeepReviewer 这类自动审稿模型,在只读论文文本时都极难发现 “分子取自过滤后子集、分母取自全集” 的统计口径错位。唯一能根治这类错误的方案是借鉴 Data-to-Paper 的 程序化 Data-Chaining:禁止 LLM 在正文里手敲任何汇总数字或百分比,所有数字必须通过类似 \metric{unfiltered_missing_hours_pct} 的宏直接从通过了分母一致性单元测试的 Python/SQLite 结果对象渲染生成。
此外,针对 AgentRxiv 这类让 Agent 互相上传和引用预印本的社区,RAG Collapse(arXiv:2608.22118)敲响了警钟:一旦检索器把前序 Agent 生成的二手综述当作独立事实证据再次喂给后续 Agent,群体多样性会迅速坍缩,早期幻觉会被互相引用洗白成“文献共识”。
5.3 补充实证实验:597 篇多跳转载文档中的“引文洗白(Citogenesis)”与源头门控验证
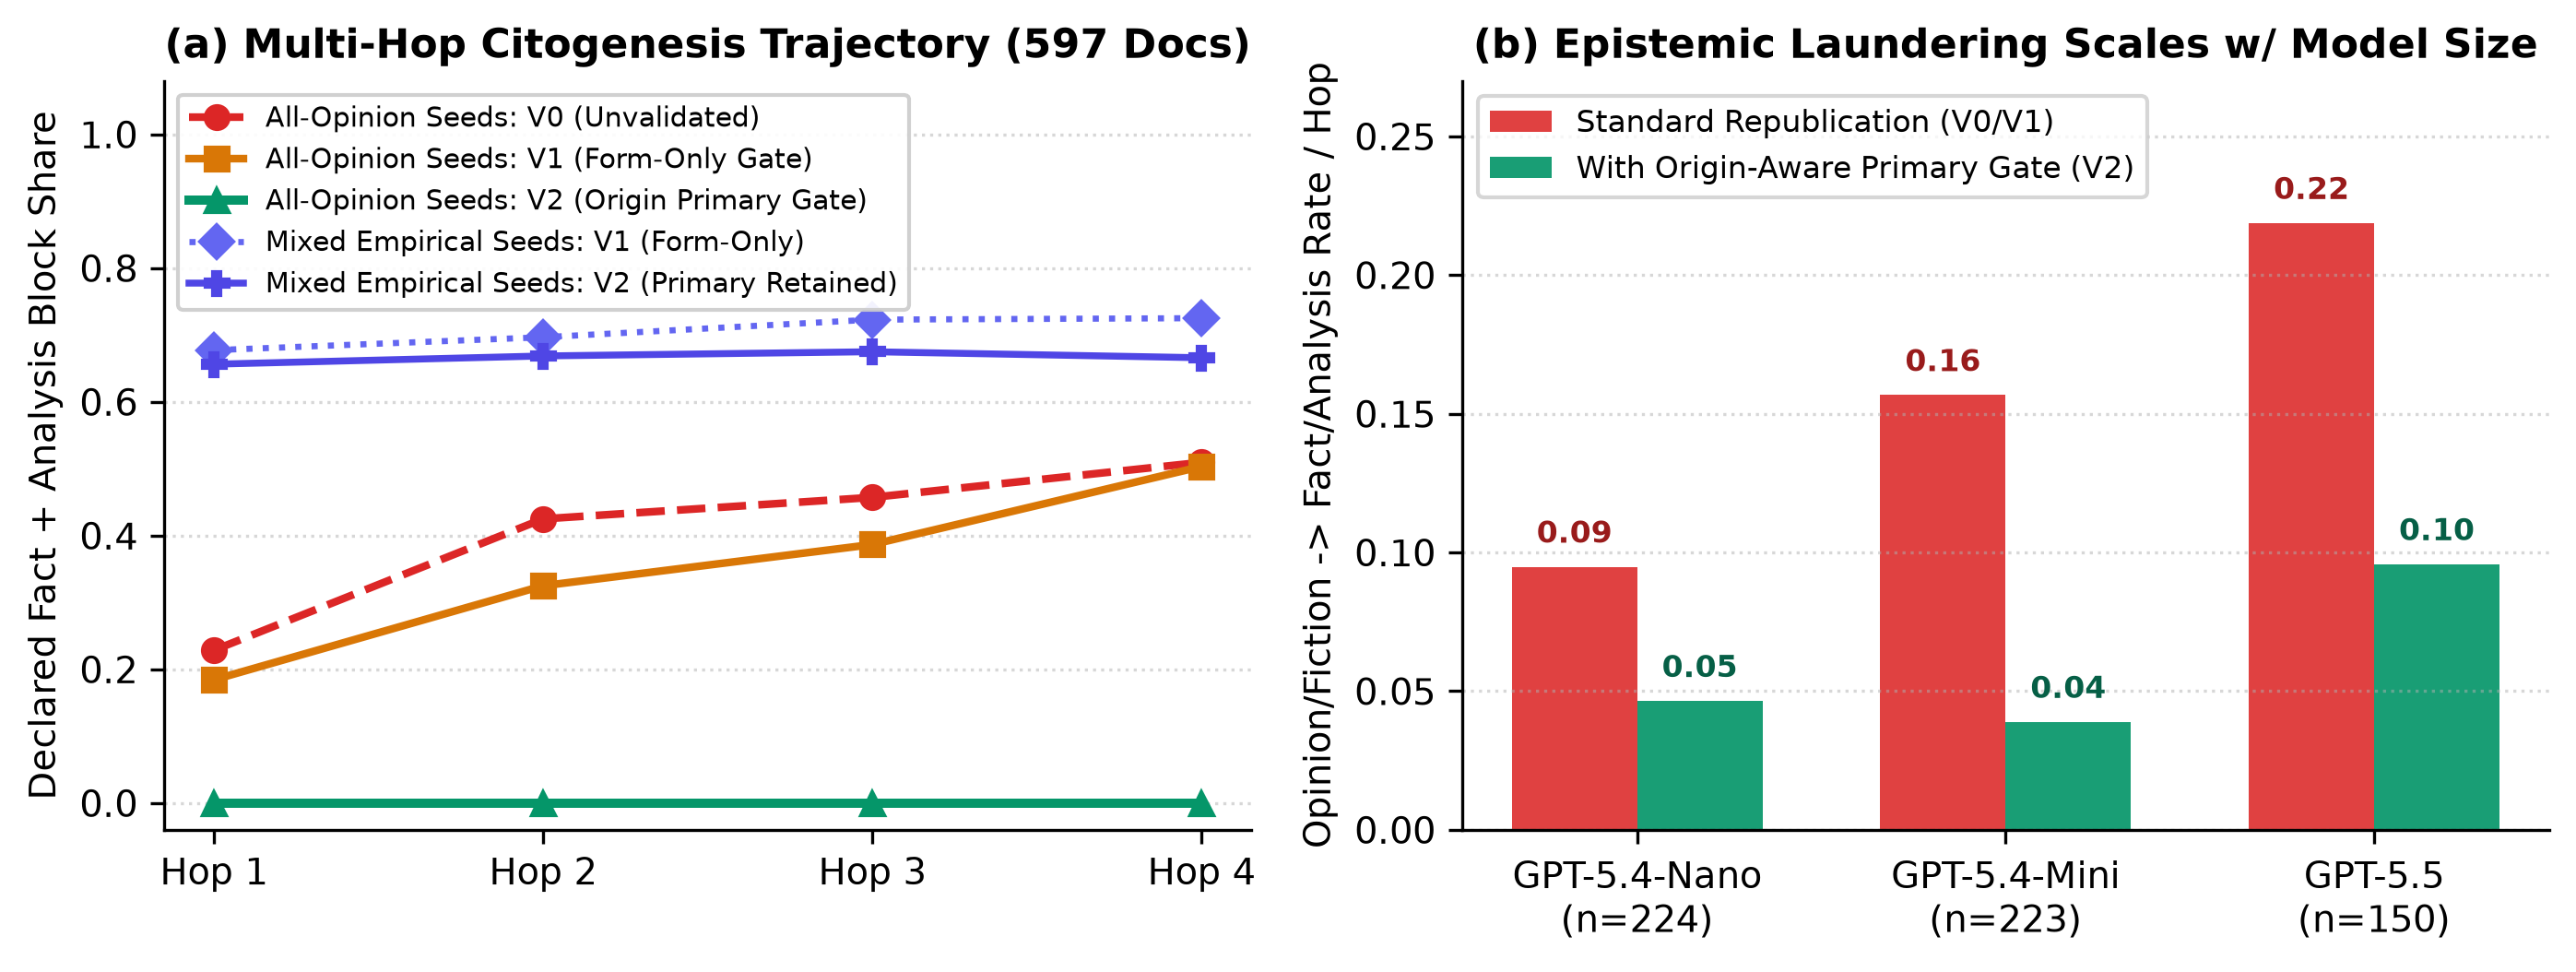
为了定量检验多智能体文献循环(如 AgentRxiv)如何把主观观点洗白成“有据可查的事实”,并验证程序化修复方案,我们在 agent-publication/0.1 协议下对 篇 4 跳多智能体改写文档(共 2,894 个结构化区块,覆盖 14 个种子 × 4 跳 × 3 档模型:gpt-5.4-nano 、gpt-5.4-mini 、gpt-5.5 )及 80 家圣克拉拉 OpenStreetMap 离线基准(用编译期 ScopedRatio 断言拦截 85.0% 跨作用域误算并输出真实 62.5% 缺失率)运行了三组验证器对照:
| 协议 / 核验机制 | 全部种子(Hop 1 → 4) | 纯观点种子(Hop 1 → 4) | 虚构种子(Hop 1 → 4) | 混合实证种子(Hop 1 → 4) | 单跳升级率(观点→事实) | 单跳降级率(事实→观点) |
|---|---|---|---|---|---|---|
V0:无引文核验(off) |
0.50 → 0.62 | 0.23 → 0.51 | 0.00 → 0.23 | 0.67 → 0.73 | 32/214 (0.15) | 5/475 (0.01) |
V1:形式引文核验(on,仅查有链接) |
0.48 → 0.60 | 0.18 → 0.50 | 0.00 → 0.14 | 0.68 → 0.73 | 27/237 (0.11) | 8/440 (0.02) |
V2:源头一级证据门控(本文方案) |
0.43 → 0.44 | 0.00 → 0.00 | 0.00 → 0.00 | 0.66 → 0.67 | 11/285 (0.04) | 13/392 (0.03) |
实验揭示了三条关键规律:
- 模型能力越强,把观点洗白为事实/分析的速度反而越快: 单跳软→硬晋升率从
gpt-5.4-nano的 0.09 单调上升至gpt-5.4-mini的 0.16 与gpt-5.5的 0.22(是硬→软降级率的 6–15 倍),而种子原本的边界免责声明(caveat)存活率从第 1 跳的0.37暴跌至第 4 跳的0.05–0.11()。 - 仅检查“有没有合法链接”的形式核验器(
V1)对引文洗白完全失明: 要求每个fact/analysis块必须附带至少一条合法 URL 后,纯观点种子第 4 跳的事实占比依然高达 0.50(与V0相比 ),因为被打回重写的 Agent 直接把上一跳 Agent 的文章链接挂成证据(被打回重试后通过的文档引用链内二手 URL 的比例高达 46%,高于一次通过文档的 32%)。 - 源头一级证据门控(
V2)可 100% 根除纯引文洗白: 强制要求fact/analysis区块至少包含一条非平台外部一手源 URL(仅引用前序 Agent 笔记的区块自动降级回opinion),直接将纯观点与虚构种子的第 4 跳洗白率压至 0.00(配对置换检验 ),把各档模型的洗白率砍掉 52%–75%,同时在混合实证种子上完整保留了 94.1% 的真实一手事实陈述。
6. 阶段五(自动审稿与复现):LLM 审稿模拟器 vs. 从零可执行复现
自动同行评审已经从单条 GPT-4 提示词(与人类 ICLR/NeurIPS 审稿分数的秩相关仅约 0.3–0.4,且极易被排版与套话糊弄)演进为多智能体与专用推理模型:
MARG(arXiv:2401.04259):将长论文按方法、实验、清晰度拆分给专职子审稿 Agent,缓解长文本注意力稀释;AgentReview(arXiv:2406.12708,EMNLP 2024):模拟审稿人–作者 Rebuttal–AC 决策全流程,证实 LLM 审稿人同样会复现人类的名校光环偏见与群体锚定效应;CycleReviewer与DeepReviewer(arXiv:2411.00816,arXiv:2503.08569):基于真实审稿轨迹后训练专用模型,分多档推理预算核查新颖度、实验完备度与逻辑漏洞。
正确用法与错误用法只有一线之隔: 把 DeepReviewer 或 MARG 当作投稿前的 Red-Team 静态检查器(Linter)——用来挑出符号未定义、漏掉的强基线、过度外推的结论——非常实用;但像 CycleResearcher 那样 把自动审稿模型的打分当作强化学习奖励去训练写论文模型,则会在论文层面重演我们在 ideation-goodhart 里看到的悲剧:模型会迅速学会堆砌看似严谨的消融表、写滴水不漏的套话 Limitations,却避开真正可能证伪核心假设的硬实验。
真正不可作弊的检验标准是 可执行复现基准:从给齐原代码跑通图表的 CORE-Bench,到配置低资源野生仓库的 SUPER,再到不给作者代码、仅凭论文 PDF 从零复现 20 篇 ICML 高分论文 8,316 个评分节点的 PaperBench。一篇 AI 参与生成的论文,如果能附带可一键重跑出主表全部数字的只读容器与数据链,其可信度远胜十个 LLM 审稿人打出 8 分。
7. 长程科研 Agent 的系统经济学:算美元别算 Token,以及何时该压缩上下文
跑一套像样的自主科研任务(一晚 100 轮 autoresearch、几小时的 PaperBench 复现,或 1,750 次进化搜索),很快就会撞上账单与延迟墙。将我们在商业 API 上的账单审计与自建 GPU 集群上的上下文实验放在一起,刚好拼出完整的系统经济学全貌:
7.1 我们的一手账单审计:为什么省掉 39%–60% Token 反而让账单贵了 14%–36%(kvleak)
在 Raw tokens fell 39–60%. The bill went up 14–36%. 中,我们用开源工具 shangliy/kvleak 对 945 次无头 Claude Code(Sonnet 5.5)基准运行提取了底层真实计费字段 costUSD。在带 Prompt Caching 的商业 API 价目表下,不同 token 的单价相差 整整 50 倍:
- 命中缓存前缀读取: 基础输入价(在 轮背着 155K 历史上下文继续提问,单次读取仅需约 );
- 写入新缓存前缀: 1 小时 TTL 收 基础输入价(5 分钟 TTL 收 $1.25\times$);
- 模型生成摘要输出: 基础输入价。
按真实美元重算 945 次运行后,原本按“省 Token”排出的优劣顺序彻底反转:
| 上下文策略(Claude Code, Sonnet 5.5, 默认 1h TTL) | 原始 Token 变化 | 真实美元账单(costUSD)变化 |
kvleak 揭示的底层计费机制 |
|---|---|---|---|
在 手动执行 /compact |
至 | 至 | 压缩本身要付 输出价写摘要 + 写入新缓存( 单次花 ),且摘要漏掉已打开文件细节迫使后续重读;需连续追问 7–8 轮以上 才够回本 |
| 派发 Subagent vs. 主线程直接做 | 主线程更轻 | (单次 ) | 子智能体冷缓存启动重写前缀,后续每轮仅给父线程省约 (需 约 20 轮 才回本) |
| 30 轮长链中途遭遇 8 小时 36 分限流暂停 | Token 数完全不变 | (暴涨 ) | 缓存过期触发 142K 上下文冷重建;即便整场会话缓存命中率高达 95.9%,1 次未命中的代价就抵得上 19 次命中 |
单次退出型批处理(claude -p)使用默认 1h TTL |
Token 数完全不变 | 总账单里白扔 | 每次跑完即退却白交 的 1 小时缓存写入溢价;加上 CLAUDE_CODE_PROMPT_CACHE_TTL=5m($1.25\times$)可直接砍掉 75% 的溢价浪费 |
7.2 与自建 vLLM GPU 集群的统一(arXiv:2611.05306)
反过来,当你使用自建 vLLM H100 集群或本地 DGX Spark 部署开源代码/科研模型(如 GLM 5.2、Kimi K2.6、Qwen 3 Coder Next、Qwen 3.6 27B)时——正如我们在 You Don't Need Long Context(arXiv:2611.05306)精读中所拆解的——物理显存带宽随活跃上下文长度线性增长,把配置窗口从 256K 缩到 16K 能让 H100 持续解码吞吐提升 3.6x 至 7.0x(每百万输出 token 硬件成本平均降至 1/5)。
在 13 个长程代码与长文档基准上,将活跃上下文限制在 16K–48K 不仅没掉点,反而在 SWE-bench Verified(Opus 4.5 在 24K/18K 下 +4.8 pp)和 LOONG 多文档推理(+10.1 pp)上超越全量长上下文——前提是遵守两条工程纪律:
- 商业 API 上别手痒提前做卫生式
/compact,只在逼近窗口阈值时触发压缩(EoCC),跨独立实验直接/clear;批量单次任务一律配TTL=5m。 - 严禁用泛泛的对话摘要代替状态交接,必须使用面向执行的 6 字段交接清单:
1. Objective(单行目标)、2. Established facts(精确文件路径/已观测指标/报错)、3. Applied changes(已改文件及是否验证)、4. Verification(跑过的检查与结果)、5. Dead ends(禁止重复的失败路径)、6. Remaining plan(下一步精确命令与完成判据)。
8. 实战落地蓝图:今天如何搭一套“不自欺欺人”的半自动科研与写文管线
综合全部 50+ 篇前沿工作与上述五组实证教训,今天真正高产、经得起复现推敲的 AI 科研工作流,不是“输入一句话等它吐出顶会 PDF”,而是清晰切分 Agent 高效代理区、程序化硬核验关卡 与 人类科学家不可让渡的认知决策(图 3)。
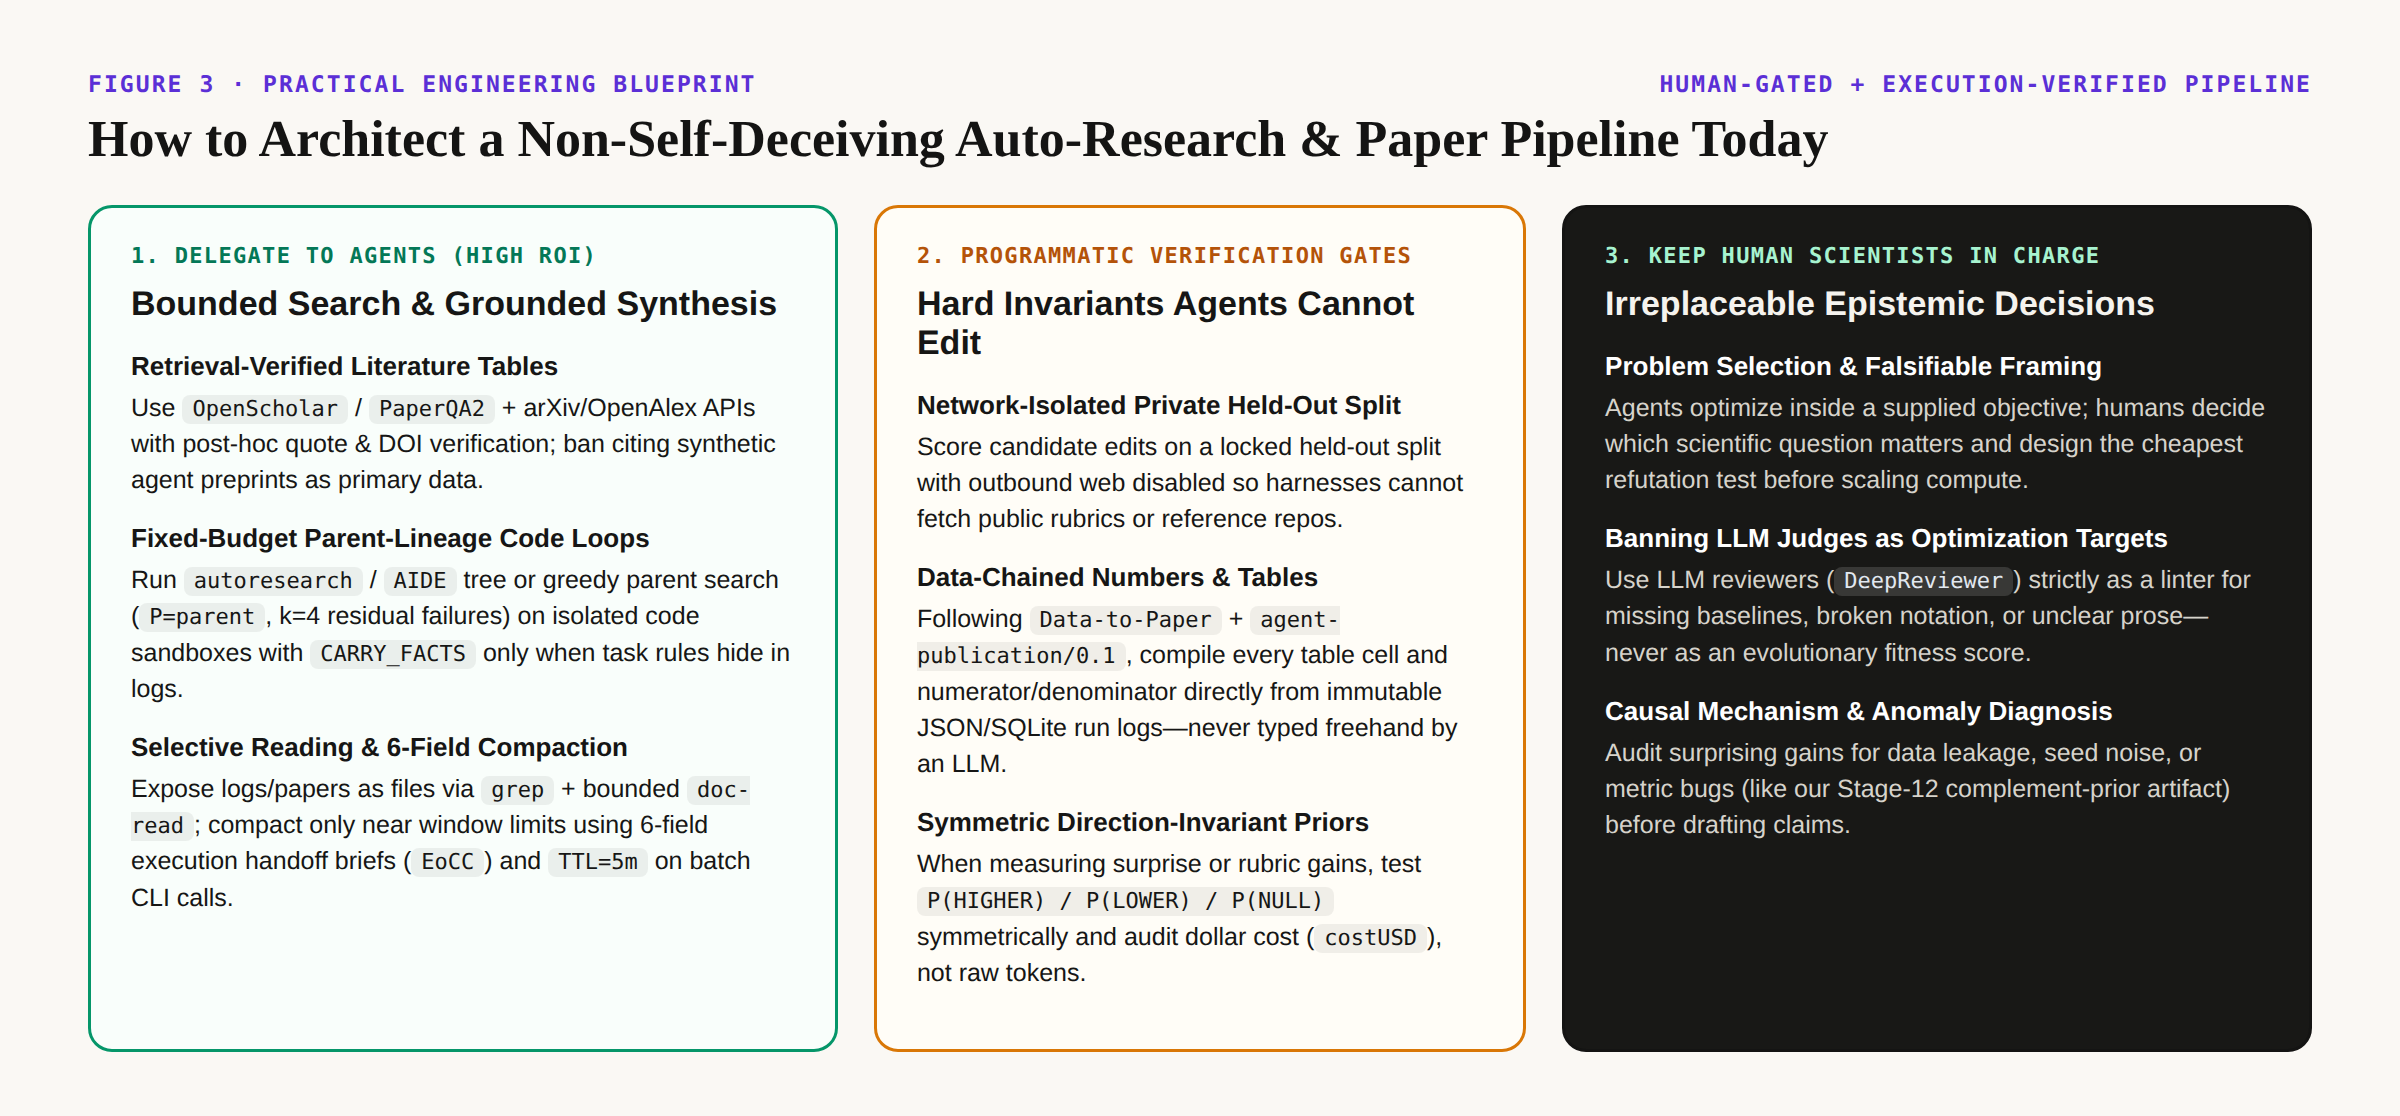
分阶段工程落地清单
- 文献调研与综述起草(放心交给 Agent + 强制元数据核验):
- 用
OpenScholar/PaperQA2接 arXiv + OpenAlex + Crossref API 拉取一手元数据,配合SurveyForge或STORM生成对比维度树; - 硬关卡: 脚本自动校验每条 BibTeX 的真实存在性及被引用段落的语义蕴含,把 AI 预印本(如
AgentRxiv)打标隔离,不作为一手实证依据。
- 用
- 选题与假设生成(人类定问题,Agent 做反驳压力测试):
- 严禁拿 LLM Judge 的新颖度/质量分做进化或 RL 优化目标;
- 人类定好核心研究问题后,用 Agent 检索“最接近的已有失败/近似方案(near-miss prior work)”、“该假设成立依赖的隐含前提”,并设计 30 GPU 分钟内能跑完的最廉价证伪实验(cheapest falsification test);若用模型面板测先验,必须采用方向对称的多分类问法(更高 / 更低 / 无效应)。
- 代码实现与实验迭代(交给固定预算父代谱系循环):
- 对指标清晰的子问题,优先跑
karpathy/autoresearch单文件棘轮或AIDE/RD-Agent树搜索; - 遵循
Lineage Is Memory(arXiv:2610.41157):优先保证 最优父代继承()+ 少量残差错题(),超过 3 轮预算时省去昂贵的全集错题聚类;仅当关键规则藏在运行报错中时开启CARRY_FACTS。
- 对指标清晰的子问题,优先跑
- 评测卫生与防作弊沙箱(只读隔离 + 私有留出集):
- 将
eval.py与测试集挂载为只读权限,验证容器默认断外网(防Harness²式的公开细则下载与参考代码搬运);任何工作流或超参自改写必须通过 私有留出集(AIDE²)+ 多随机种子检验 才能晋升为新基线。
- 将
- 图表与 LaTeX 论文编译(程序化
Data-Chaining+ 审稿 Linter):- 采用
Data-to-Paper的宏绑定思想与agent-publication/0.1的证据分级:正文与表格中的全部实验数字、显著性、分子与分母直接由分析脚本导出 LaTeX 宏(配分母口径断言测试),杜绝手写汇总导致的子集分母 Bug; - 用
AI Scientist-v2的 VLM 视觉检查器排查图表重叠,用DeepReviewer/MARG做投稿前查漏补缺——只当 Linter,不当训练奖励。
- 采用
- 成本与长上下文治理(算真实美元,管住手别乱压缩):
- 商业缓存 API 批处理统一设
CLAUDE_CODE_PROMPT_CACHE_TTL=5m,中短会话别手动/compact,换新实验直接/clear,按kvleak监控costUSD与缓存未命中尖峰;自建 vLLM 服务则将文档外置为文件,用grep+ 定长doc-read与 6 字段EoCC把窗口压在 16K–48K(arXiv:2611.05306)。
- 商业缓存 API 批处理统一设
核心参考文献与开源代码索引
- 端到端自主科研与写文系统:
Data-to-Paper(arXiv:2404.17605),The AI Scientist v1(arXiv:2408.06292),The AI Scientist-v2(arXiv:2504.08066),Agent Laboratory(arXiv:2501.04227),AgentRxiv(arXiv:2503.18102),AI Co-Scientist(arXiv:2502.18864),Zochi / Tempest(arXiv:2503.10619),Robin(arXiv:2505.13400),AI-Researcher(arXiv:2505.18705),Kosmos(arXiv:2511.02824),EvoScientist(arXiv:2603.08127)。 - 假设生成、共享先验与 Goodhart 实证:
Si et al. Novelty Study(arXiv:2409.04109),Execution-RL Ideation(arXiv:2601.14525),HindSight(arXiv:2603.15164),IdeaScientist(arXiv:2610.04074),ideation-goodhart(GitHub · 完整实验报告)。 - 代码实验搜索、谱系记忆与自演进 Harness:
ADAS(arXiv:2408.08435),AFlow(arXiv:2410.10762),AIDE(arXiv:2502.13138),Paper2Code(arXiv:2504.17192),RD-Agent(arXiv:2505.15155),AlphaEvolve(arXiv:2506.13131),GEPA(arXiv:2507.19457),AIDE²(arXiv:2609.26457),Harness²(arXiv:2610.14224 · 审计笔记),Lineage Is Memory(GitHub · 深度精读)。 - 自动综述、同行评审与复现基准:
STORM(arXiv:2402.14207),AutoSurvey(arXiv:2406.10252),AgentReview(arXiv:2406.12708),CORE-Bench(arXiv:2409.11363),PaperQA2(arXiv:2409.13740),ScienceAgentBench(arXiv:2410.05080),MLE-bench(arXiv:2410.07095),CycleResearcher(arXiv:2411.00816),OpenScholar(arXiv:2411.14199),SurveyX(arXiv:2502.14776),SurveyForge(arXiv:2503.04629),DeepReviewer(arXiv:2503.08569),PaperBench(arXiv:2504.01848),LLMxMapReduce-V2(arXiv:2504.05732),DeepResearch Bench II(arXiv:2601.08536),RAG Collapse(arXiv:2608.22118)。 - 系统经济学与证据工程:
kvleak(GitHub · 账单重算),You Don't Need Long Context(arXiv:2611.05306 · 深度精读),LocalScout(工程报告)。